Anthropic 在 周二发布了 Claude Opus 5.5,这是该公司称之为Claude 5.5系列的第一个模型。Anthropic表示,新的模型在大多数任务上的表现相当于其最昂贵旗舰产品Claude Fable 5.1。
有趣的是,这个模型的运行成本比它替代的Opus 5低20%,并且比公司的尖端产品Fable 5.1便宜60%。
Myriad:哪家公司将下一个上市? 点击预测。
看来,这个模型非常强大。它在版本(5.5相比于Fable的5.1)和系列(Opus是公开可用的最大模型,Sonnet紧随其后,而Haiku是最小的模型)方面都是最先进的。
Anthropic承认,Fable和Opus之间的差距比其基准得分所暗示的要小,但由于公开可用,且每个token的价格更便宜,使得这成为大多数Claude用户的显而易见的选择。
Opus 5在7月发布时对Fable 5的定价和得分均低,然而Fable 5.1在九月初发布并扭转了局面,在Anthropic发布的每个基准上均超越了Opus 5。
Opus 5.5再次缩小了差距,这次是在价格方面而不是原始得分上。Lovable,一个在7月对Opus 5进行自身编码测试的开发平台,在Anthropic分享的声明中表示,早期的模型“更加稳定,运行之间的方差要小得多”,这正是Anthropic现在再次提出的效率论点。
Opus 5.5也是Anthropic自首席执行官Dario Amodei发布了一篇呼吁行业放慢脚步的文章以来发出的第一个模型,他主张AI能力的提升已经超出了用于控制它们的安全测试。“我们必须放慢提升AI模型能力的步伐,”Amodei本月早些时候写道。
Anthropic通过代理编码来衡量大部分进展——由AI代理进行的工作,这是一种自主采取多步骤动作的模型,而不仅仅是回答单一提示。
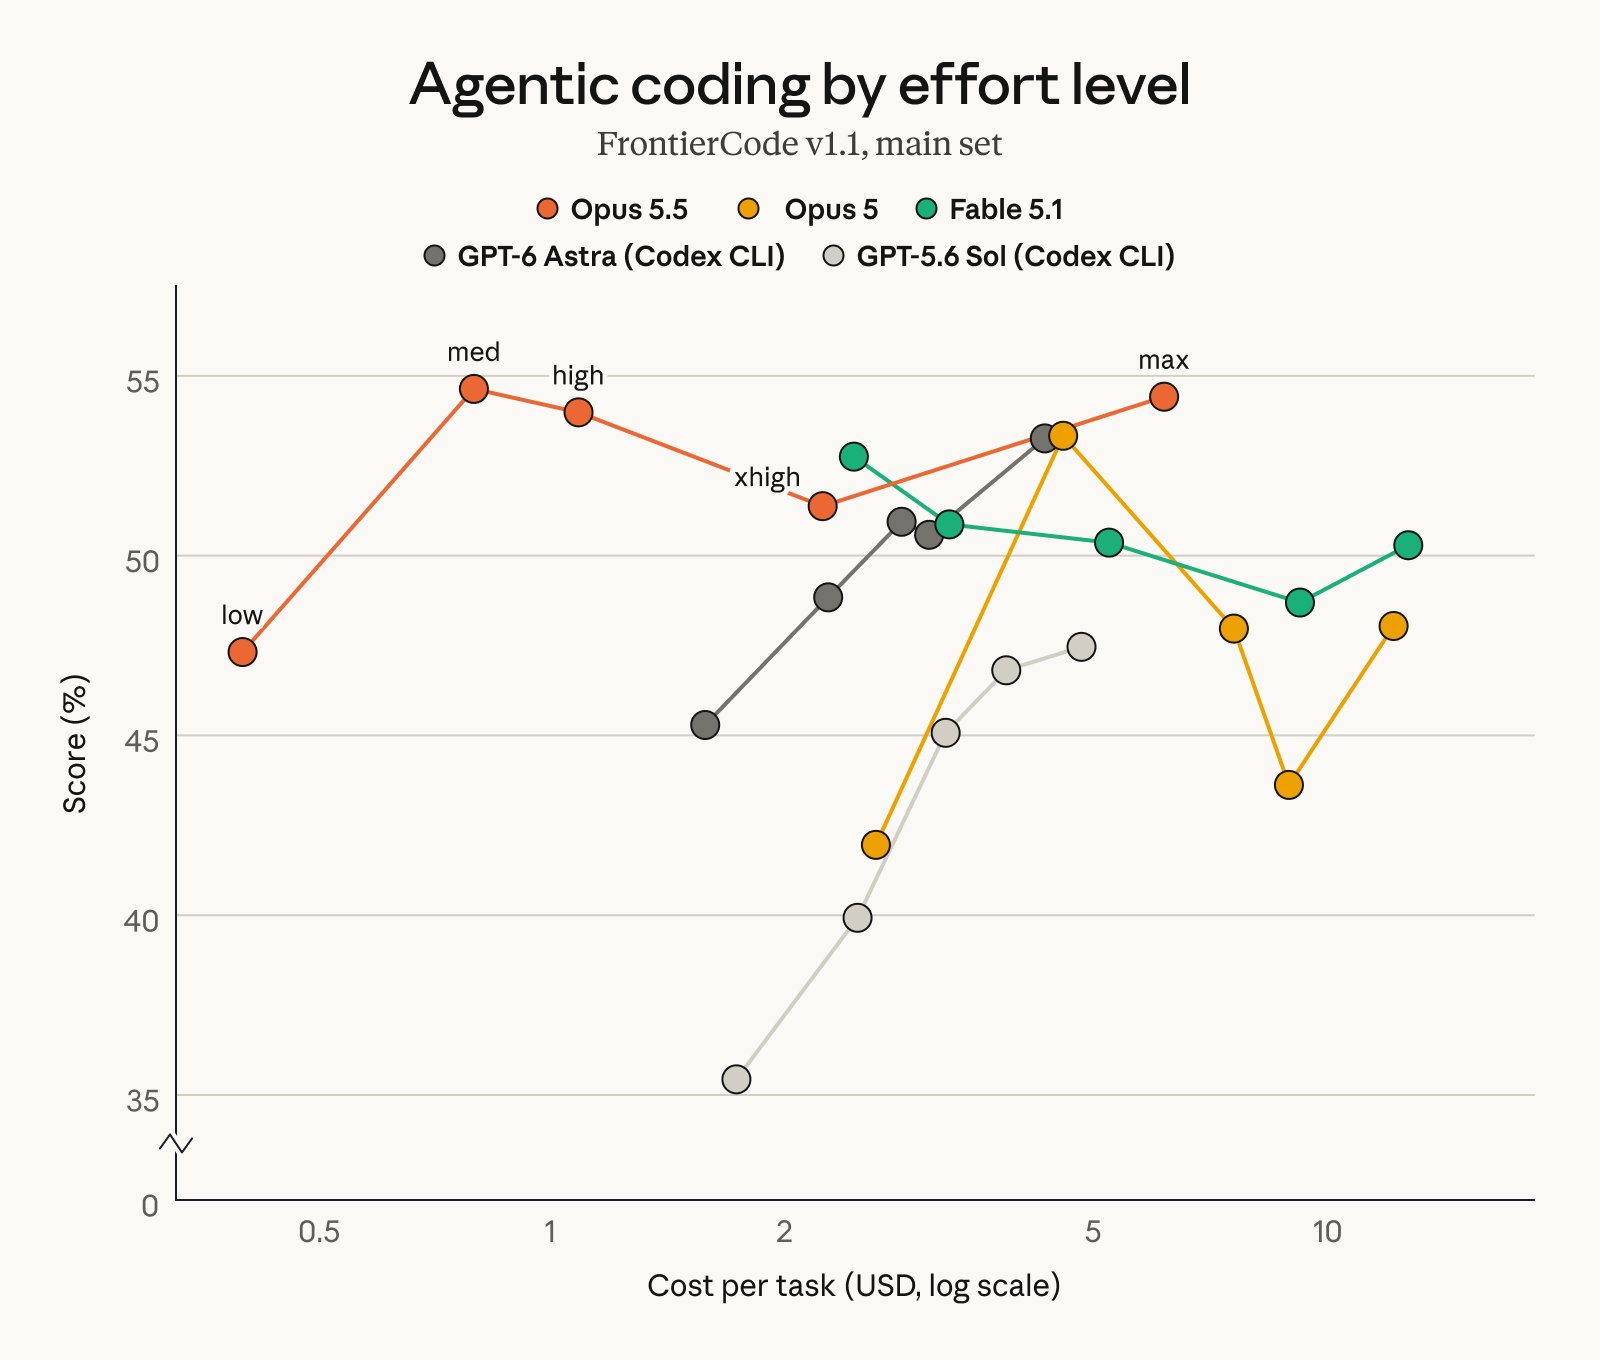
在Terminal-Bench 4.0中,该基准测试代理是否能够在命令行界面内完成复杂的专业任务,并将结果以完成任务的百分比进行评分,Opus 5.5达到了66.4%,领先于Fable 5.1的55.8%和GPT-6 Astra的57.9%。FrontierCode检查代理的代码更改是否会在使用相同通过率评分的真实工程流水线中被合并,Opus 5.5的得分为54.4%,而Fable 5.1为50.3%。
在GDPval-AA v2.1上,该基准使用Elo系统评分44个职业的现实专业工作,该系统用于衡量相对技能而非简单百分比,Opus 5.5得分1846,超过Fable 5.1的1735和Opus 5的1708。
然而,Opus 5.5并不是在所有地方都领先。在AutomationBench,这是一个由Zapier构建的基准,评分代理是否能够在没有人类帮助的情况下完成整个商业工作流程,GPT-6 Astra的41.4%略微领先于Opus 5.5的40.0%。
在Terminal-Bench-Science 0.1上,该基准测试在命令行环境中进行代理科学研究,使用相同的通过率方法,Astra的64.6%比Opus 5.5的58.7%有更大的优势。
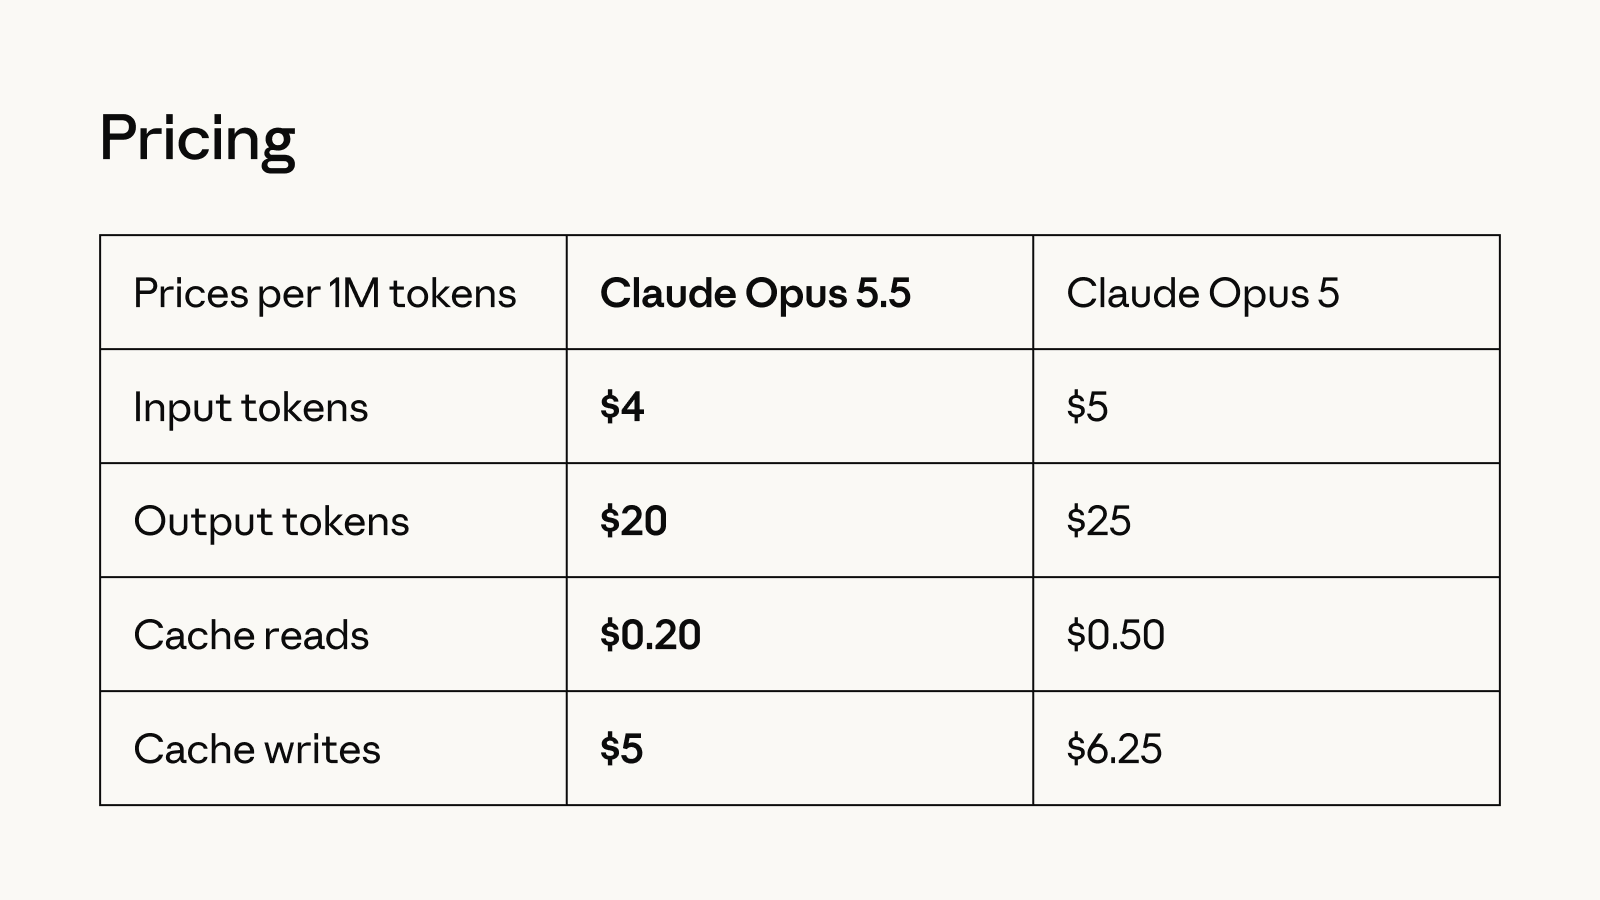
更大的卖点是成本。输入tokens——模型读取和写入的文本块,按百万计价——Opus 5.5的费用为每百万$4,而Opus 5的费用为每百万$5,输出tokens的费用从$25降至$20。缓存读取,这意味着重用模型已处理的上下文,而不是从头开始重新处理,进而降低了长时间代理编码会话的大部分成本,从$0.20下降60%至每百万tokens。
由于Opus 5.5在这两项能力上与Anthropic的Mythos级模型相匹配——该公司最受限制的等级,专门为经过审核的网络安全和生物研究人员保留——它以与Fable 5.1相同的安全措施发布。
大多数网络安全任务会自动重新路由到较旧的Opus 4.8,这也是许多开发者和用户之前抱怨过的事情。
Opus 5.5现在在Anthropic的平台上实时上线,包括亚马逊云服务、谷歌云和微软Azure。Anthropic表示,Sonnet 5.5和Haiku 5.5将在接下来的几周内推出,并在全系列中降低相同的价格。
免责声明:本文章仅代表作者个人观点,不代表本平台的立场和观点。本文章仅供信息分享,不构成对任何人的任何投资建议。用户与作者之间的任何争议,与本平台无关。如网页中刊载的文章或图片涉及侵权,请提供相关的权利证明和身份证明发送邮件到support@aicoin.com,本平台相关工作人员将会进行核查。


