埃隆·马斯克的 xAI 在周一下午发布了 Grok 4.7,这是迄今为止最好的模型,称其为“在同样的价格和速度下比 Grok 4.6 有显著的改进”。
此次发布是在几次明显的延期之后进行的。自七月底以来,马斯克已将时间表往回推至少五次:“四周”,然后是“几周”,接着是“3到4周”,然后是在9月1日说“10天”,最后在9月11日说“需要几天时间来完善”。
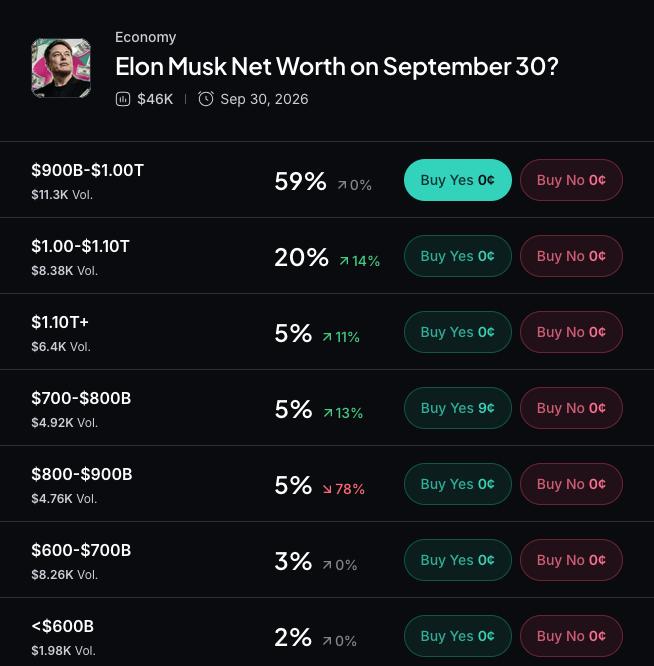
Myriad:埃隆·马斯克的净资产将是多少? 点击进行预测。
xAI 表示,该模型在解决复杂问题时花费的时间更长,而且比 Grok 4.6 更频繁地进行自我核查,同时具备公司称之为的最强安全防护措施。
马斯克 在 X 上跟进,称 Grok 4.7 “是一种智能、速度与低成本的强大结合”。这次没有等待名单——现在在 Grok 应用程序、Cursor、Grok Build 和 xAI API 中实时发布。
Grok 4.7 拥有 2.1 万亿个参数,比 Grok 4.6 的 1.5 万亿增加了 40%。费用为每百万输入代币 2 美元,每百万输出代币 6 美元。参数是模型在训练过程中调整的内部设置,更多的参数通常意味着更强的学习模式的能力,而代币则是 AI 模型可以注册或生成的信息的基本单位。
xAI 还整合了来自 SpaceX 的补充训练数据,即马斯克的火箭公司:Starlink 卫星遥测、制造记录和工程故障日志。其卖点是该模型在硬件和物理系统方面的推理能力优于任何纯粹基于互联网文本训练的模型。
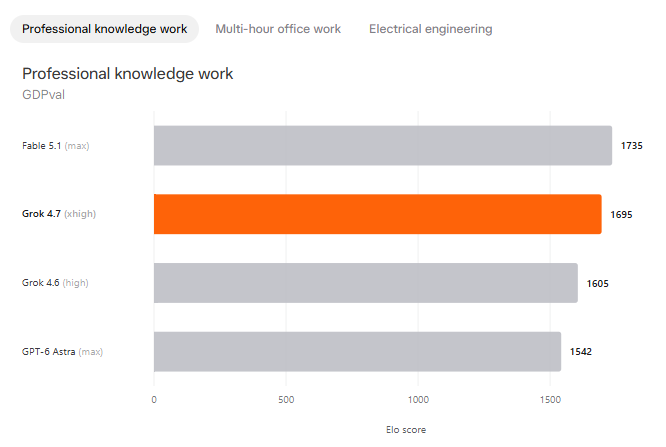
也就是说,基准分数讲述了一个熟悉的故事。GDPval 测量一款模型在真实的、具有经济价值的知识工作上的表现——法律备忘录、电子表格、幻灯片文稿——使用由每个领域中的专业人士审核的任务,并将其评分为 Elo 等级,这与国际象棋使用的头对头排名系统相同。
Grok 4.7 在 GDPval 上达到了 1695。Claude Fable 5.1 在排行榜上以 1735 领先。
由人工分析公司构建的 AA-Briefcase 测试了将多小时办公室工作串联在一起的任务,包括研究、分析和文档制作,也在 Elo 等级上进行评分。Grok 4.7 的得分为 1657,而 Fable 5.1 的得分为 1678。结果相同,测试不同。
CursorBench 4.0 是 Cursor 在其编辑器内针对真实编码任务的基准,绘制了每个任务的准确性与成本和代币消耗之间的关系。Grok 4.7 位于中间:每个任务的成本高于GPT-5.6 Sol的继任者 GPT-6 Astra 和 Claude Sonnet 5,但仍低于 Fable 5.1,在每个价格点上都胜出。
这并不是 xAI 的新模式。Grok 4.5 在七月发布时拥有行业中最大的训练集群,并在 Claude 和 OpenAI 的模型之后名列第三。在此之前,Grok 4.20 在速度和个性方面进行了权衡。Grok 4.6 在编码自主性方面也落后于前沿队伍。
这一切并没有使 Grok 4.7 对那些通过 X、独立应用程序或他们的特斯拉仪表盘与之对话的数百万人而言成为一款糟糕的产品。这意味着最有可能回答您问题的模型,或为您的汽车语音助手提供动力的模型,运行在一个其制造者的基准将其评级置于梯子顶端之下的系统上。
这个差距就是为什么价格标签对大多数人而言比排行榜位置更重要的原因。即使在原始能力上落后于 Anthropic 和 OpenAI,xAI 在每个代币的成本上也一直在进行降价,下注“足够好、便宜且无处不在”胜过“最好,但更贵”以满足日常使用的绝大部分需求。
马斯克在发布前几天已经降低了期望,写道 Grok 4.7 应该与 Anthropic 的 Claude Opus 5.0 “大致相当”,而不是更新的 Opus 5.1,并且多模态性能仍需改进。
在同一篇文章中,他勾勒出了接下来的三个模型:Grok 4.8 作为一个重要的提升,Grok 4.9 属于 “Astra/Fable 类”,Grok 5 作为可能的前沿领导者。这些升级尚未确定发布日期。“我们拭目以待,”他 写道。
免责声明:本文章仅代表作者个人观点,不代表本平台的立场和观点。本文章仅供信息分享,不构成对任何人的任何投资建议。用户与作者之间的任何争议,与本平台无关。如网页中刊载的文章或图片涉及侵权,请提供相关的权利证明和身份证明发送邮件到support@aicoin.com,本平台相关工作人员将会进行核查。


