人麻了,前几天不是都喊着模型要放慢吗。
怎么这模型跟不要钱一样往外面扔啊。
昨天Grok 4.7 PK MiMo v2.6,是给今天这两大哥演个前戏是吧。
今天凌晨,OpenAI的GPT-6 Sol和GPT-6 Luna,以及Anthropic的Claude Opus 5.5,都正式发布。
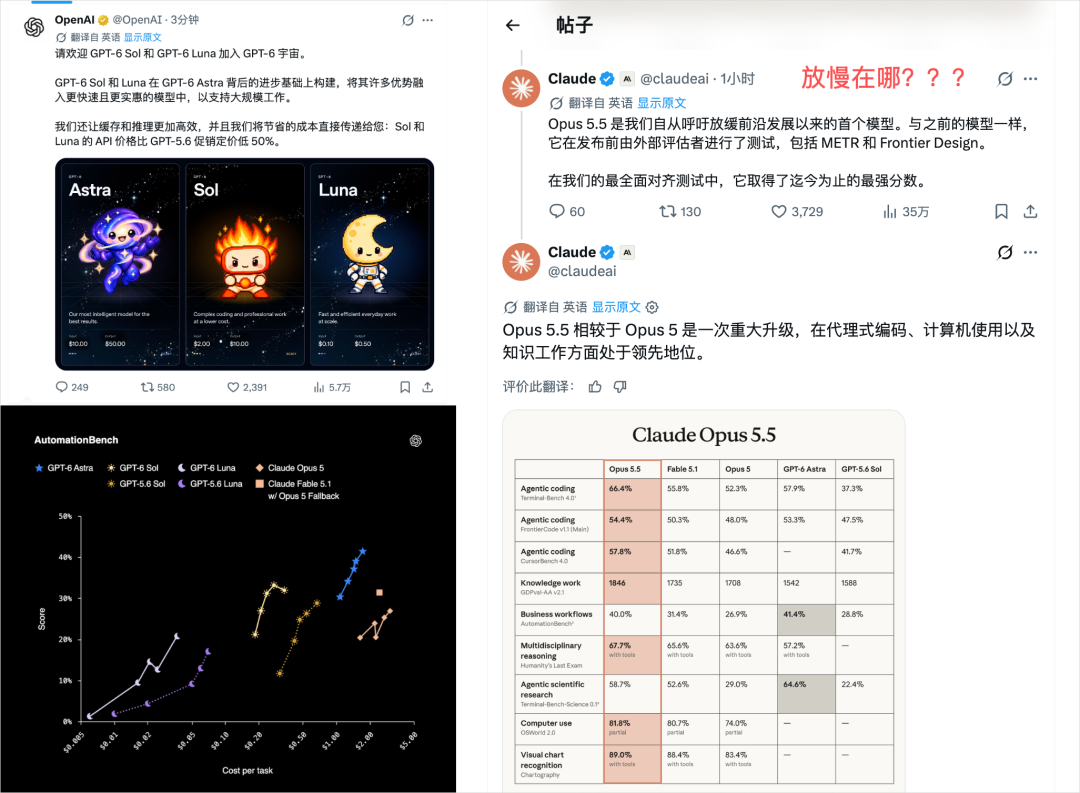
我真的挺想问问,天天一个个说着放慢,放慢在哪了这都是。
全是渣男。
而且这个剧情,我总感觉莫名眼熟,然后翻了一下历史文章。
上一次,GPT-5.3 Codex对轰Claude Opus 4.6,今天直接历史重演了。。。
只不过,Claude Opus 4.6,变成了Claude Opus 5.5。
GPT-5.3 Codex,变成了GPT-6 Sol。
两家公司还是这两家公司,还是那个不服就干的死对头。
一个一个说吧。
一. Claude Opus 5.5
先说Claude。
坦率的讲,我再怎么讨厌Anthropic,再怎么觉得这家公司是个傻逼,他们在再怎么封我号,客观的讲,Claude依然是我心中最好、最全面的那一档模型。
我至今依然记得我用Claude Fable 5给我带来的震撼。
而这次Claude Opus 5.5,是Anthropic全新的Claude 5.5系列里的第一个模型,而且我印象中,很少Claude会一次性跨这么多的版本号。
并且我自己临时体验下来(不要问我为啥封号了还能用,直接买的次抛号,用个2小时就会被封的那种。。。),Opus 5.5在整个的沟通上,让我有一种,回到了Opus 4.6的感觉,活人感很强。
虽然他们给这玩意的定位,其实就是Claude系列的性价比模型,但是确实有一种让我想起了当年的白月光。
基本信息我总结了一下,大概是这样的:
模型名 | claude-opus-5-5 |
上下文 | 1M Token |
最大输出 | 128K Token |
可靠知识截止 | 2026年6月 |
思考 | Adaptive Thinking,始终开启 |
默认努力等级 | medium |
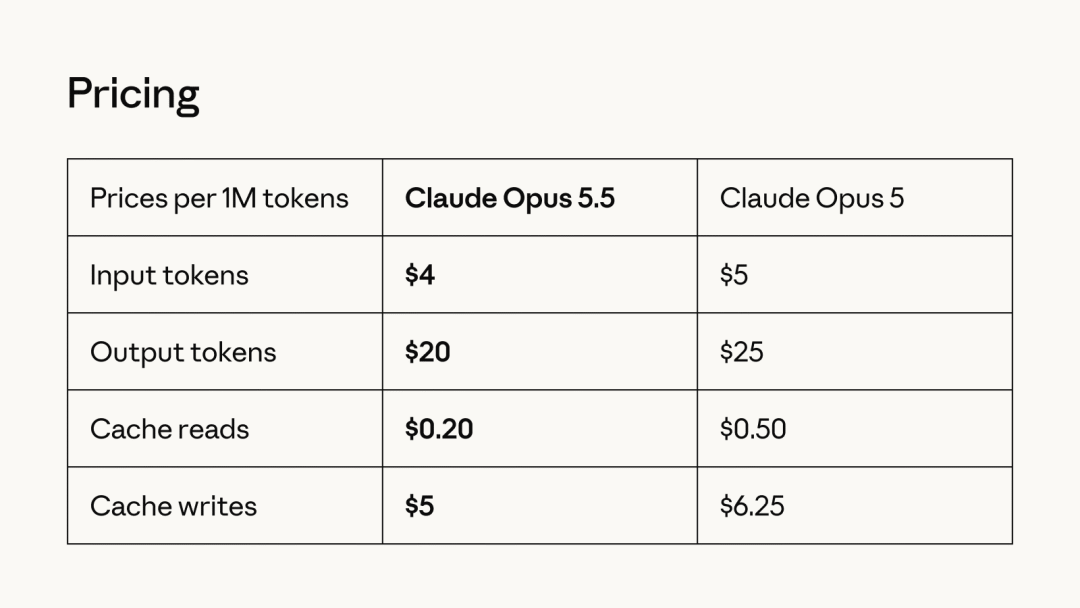
输入价格 | 4美元 / 百万Token |
输出价格 | 20美元 / 百万Token |
缓存读取 | 0.2美元 / 百万Token |
5分钟缓存写入 | 5美元 / 百万Token |
1小时缓存写入 | 8美元 / 百万Token |
相比上一代Opus 5,整体的工作成本,可以直接下降40%。
同时,输出速度相比Opus 5还快了30%以上。
目前在一些非大型的工作上,Opus 5.5已经可以做到Fable 5.1级别的表现,大型高难工作,依然需要Fable级模型上场。
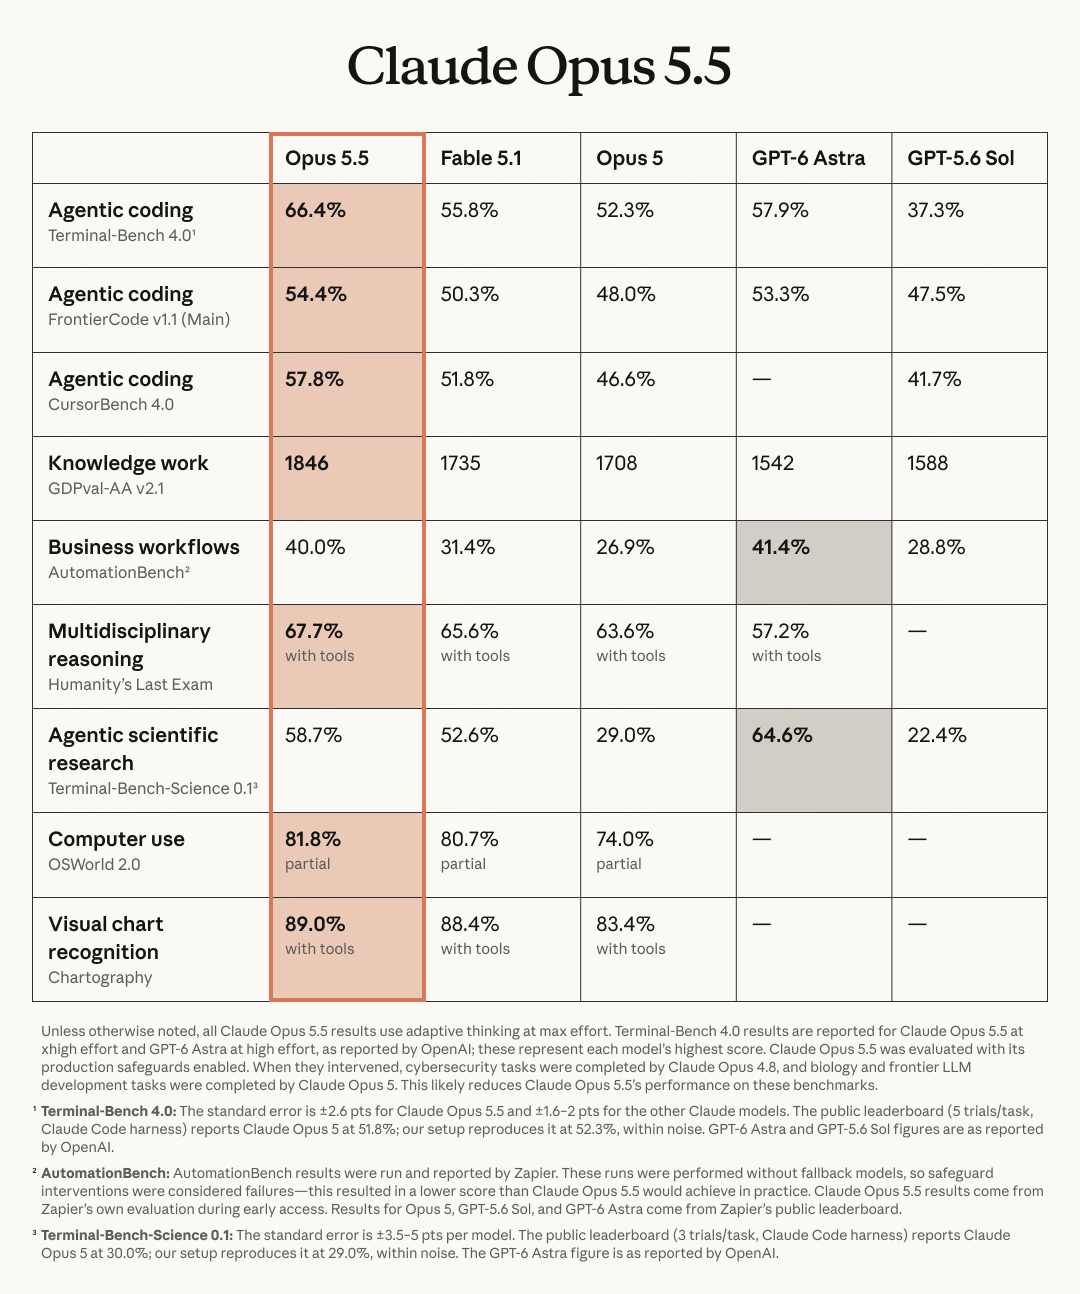
在Coding任务上,基本就是现在的SOTA了。
比如Terminal-Bench 4.0这种反映在真实终端环境里完成复杂、多步任务的能力,Opus 5.5刷新了最高分66.4%。
只要涉及到Coding的,基本上都SOTA了,很像最开始Opus 5出来的时候,在Coding的执行上全面超越Fable 5一样。
但是有两个东西不太一样,Terminal-Bench-Science这个任务是偏科研任务,Opus 5.5是58.7%,这里Astra反而更高,64.6%。
AutomationBench也一样,这个任务其实就是跨软件工作,Opus 5.5是40.0%,GPT-6 Astra是41.4%。
还有那个Computer Use,虽然GPT-6 Astra没分,但是所有人都知道这玩意不可能会差,它是绝对的SOTA。
从这些地方也能看出来Anthropic和OpenAI这两家公司卷的一些差异化发展方向,Anthropic更偏向于Coding能力,同时审美极强,他们也相信Coding才是通往AGI之路的基石,但是OpenAI更加专注的是全面的Agent能力,包括推理、软件操作、科研等等。
但坦率的讲,单纯的去看某一个维度的评测集,我觉得是完全无法去评估一个模型真正的质量的。
就像你知道,即使是开发产品,还有一个很核心的东西,是你最前面的规划和架构设计能力,这玩意Fable就是神,它依赖于你的大参数,依赖于你的世界知识,依赖于你的智能涌现。
你说Opus 5.5确实是能在某些特定的执行上面超过Fable,但是你说整体Opus 5.5要比Fable强?那我觉得你不如信我是秦始皇。
整体上Claude Opus 5.5,基本上就是Fable 5.1自家的官方蒸馏模型了。
在很多垂直的场景里面可能会更强,并且参数量更小,速度更快,更加便宜,但同时也会带来Token的浪费,这里其实是一个陷阱,一旦在高难任务上,一些非旗舰模型反而会持续不断的疯狂思考,疯狂尝试,但是又出不去一直解决不了问题,反而会比旗舰模型更加烧钱。
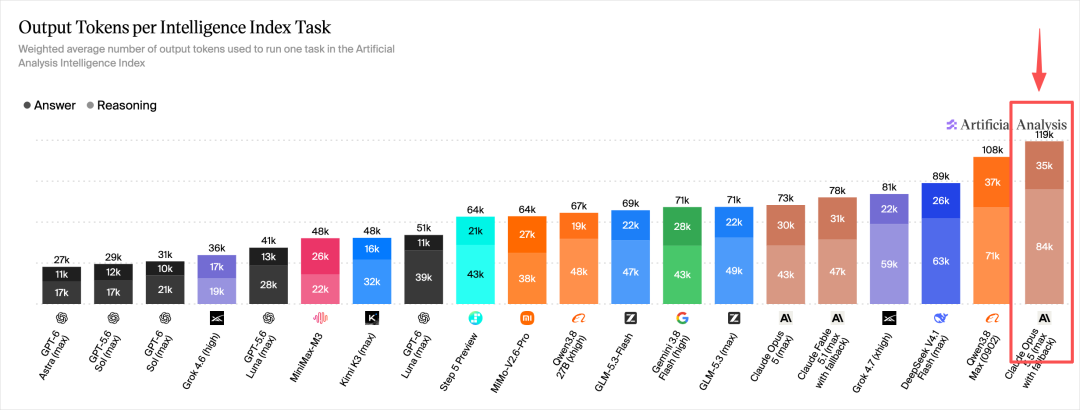
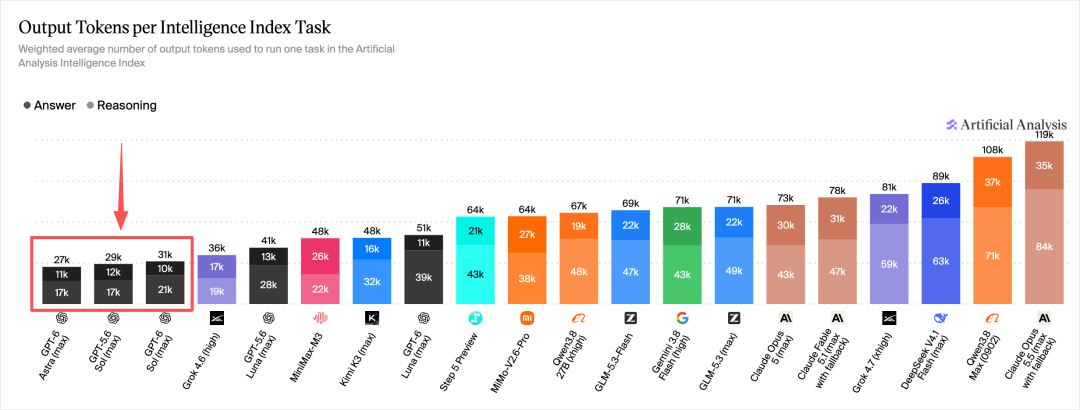
就像Opus 5.5确实很强,但是他的每任务输出Token数直接爆炸了,所以其实他的很多的智力是靠用超长的推理来去换来的,这个弊端就是,一旦陷入困境,就原地爆炸。
所以Anthropic也是如此提示的。
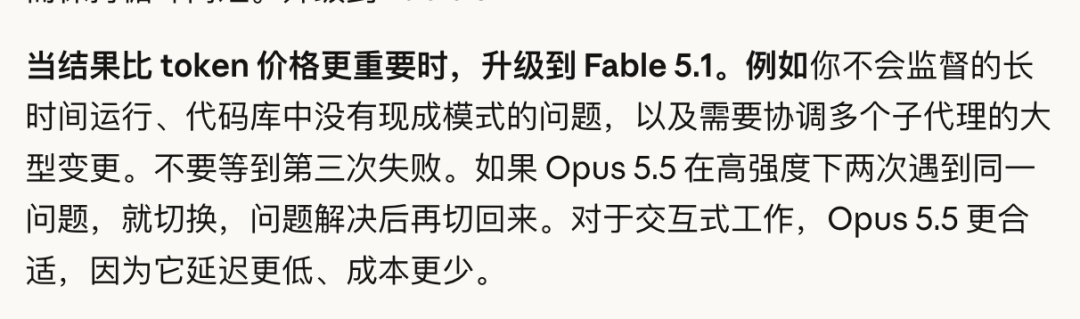
当你的结果很重要的时候,一定要用最高级的模型。
然后可以看看X上大佬们跑的Claude Opus 5.5的case,还是蛮惊艳的,特别是在审美和细节上,有了巨幅加强。
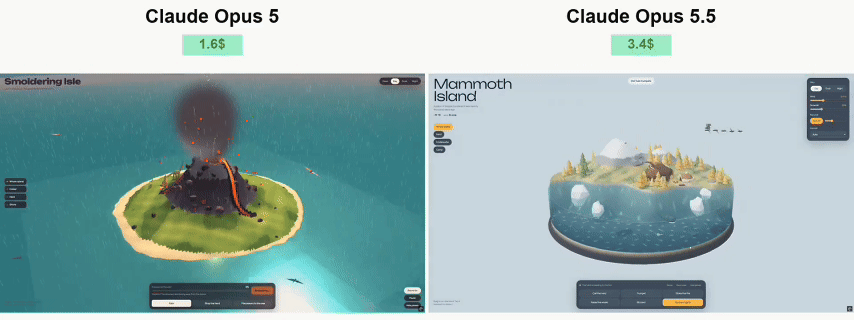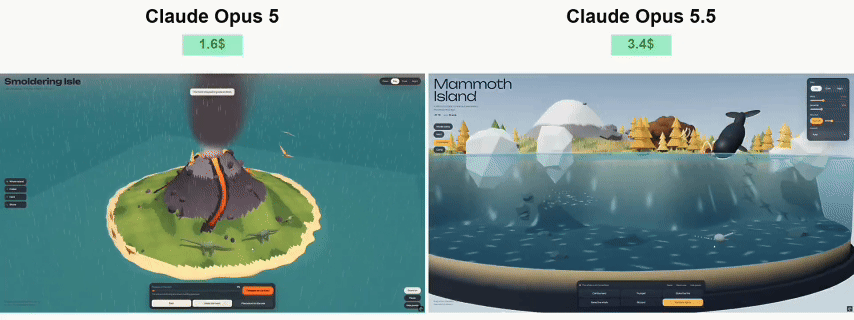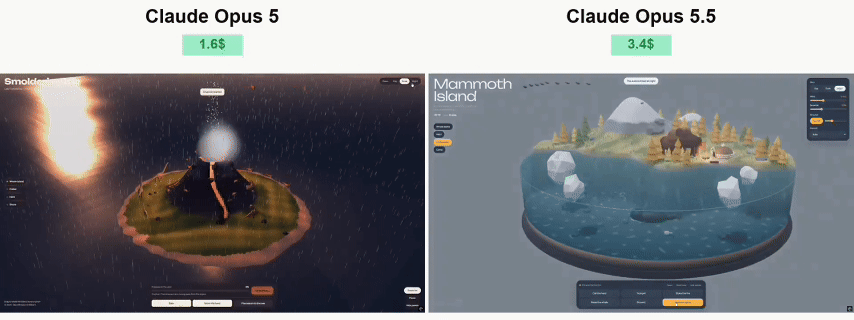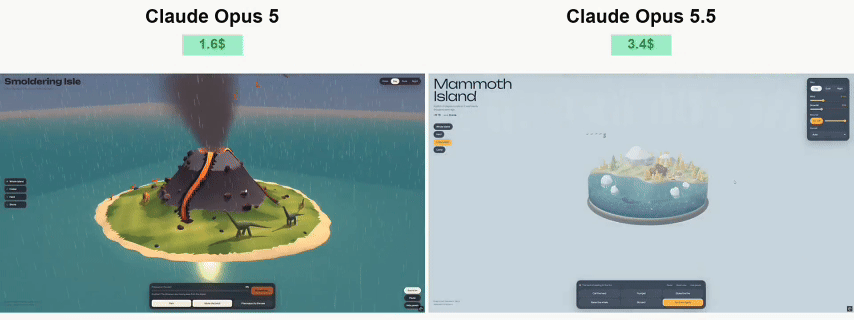
来自@notjazii的对比GPT-6 Astra和Claude Opus 5.5的测试,在部分场景下,甚至比GPT-6 Astra更加精细一点:
但代价就是,相比于GPT-6 Astra,更慢更贵。
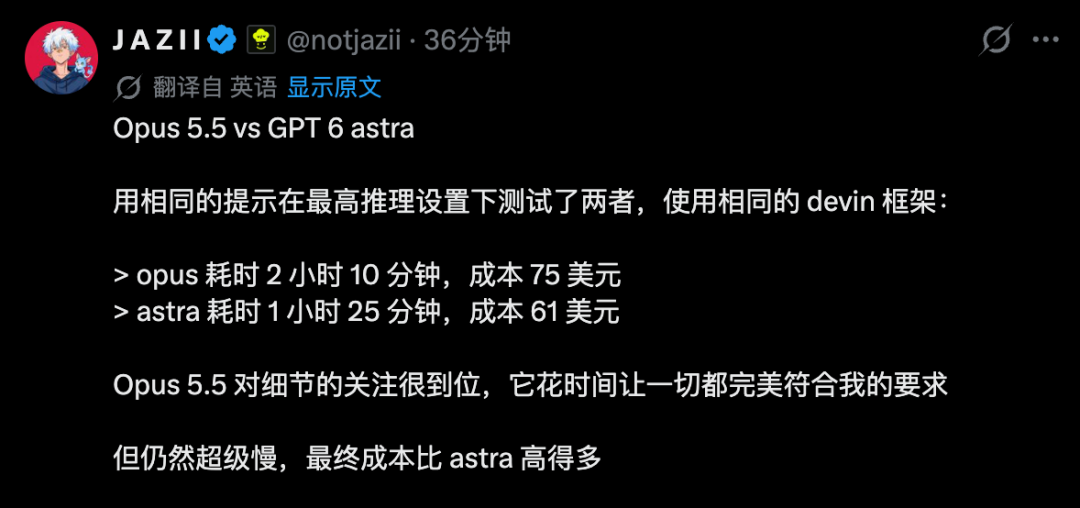
不过对于Opus 5.5来说,将其与GPT-6 Astra相比,这本身就是一种赞誉了。
Opus 5.5这次还强化了沟通。
Anthropic说他们收到Opus 5最多的反馈之一,就是,有时候写东西比较绕、术语多、表达不够直接。
5.5会把最重要的信息放在前面,减少奇怪措辞和没必要的解释。
同时在创作上,也有Claude 4.6的感觉了。
所以呢,总结来说,Claude Opus 5.5是一个我觉得非常棒的模型。
Anthropic把很多过去只有旗舰模型才能干的活,下放到了一个终于可以常驻使用的价位上,估计也是过去OpenAI给的压力太大了。
他们自己的成本指南直接建议:
日常你盯着干的Feature、Debug、Code Review,用Opus 5.5。
真正结果比Token价格更重要、长时间无人监督、或者Opus 5.5连续失败的,再切Fable 5.1。
Fable开始越来越像专家级顾问。
Opus 5.5更像主力员工。
这就是Claude今天的新模型。
二. GPT-6 Sol和Luna
终于到我能正常用的东西了。
GPT-6 Sol和Luna。
因为你claude再怎么好,我也就是一个次抛,也不是常年能用的东西,没有用啊。
所以呢,没有办法,主力依然还是GPT-6。
特别巧的是,我前几天写GPT-6 Pro+MCP那篇文章的时候,还专门写了一句:
“GPT-6 Sol大概率马上就上了,上了以后执行这块,我可能会无脑切GPT-6 Sol,只有高难任务才切GPT-6 Astra。”
然后,终于来了。
目前,Codex中已经上线,直接可用。
过去GPT-6 Astra最被人诟病的就是太贵,额度完全不够用。
那这次,GPT-6 Sol和Luna,就是直接奔着降成本来的。
Astra依然是OpenAI最强的模型。
最困难、最重要、不想做任何妥协的工作,继续用Astra。
但是现实世界里的工作,有不同的规模、节奏和预算。
所以GPT-6 Sol和Luna存在的意义,跟Fable 5.1和Claude Opus 5.5的关系一样:
把Astra这代训练方法带来的能力,下放到更快、更便宜的模型。
和Claude几乎是在同一天,讲同一件事情。
谁能用更少的钱,买到更多智能。
这就是帕累托前沿。
价格上面,新一代定价如下。
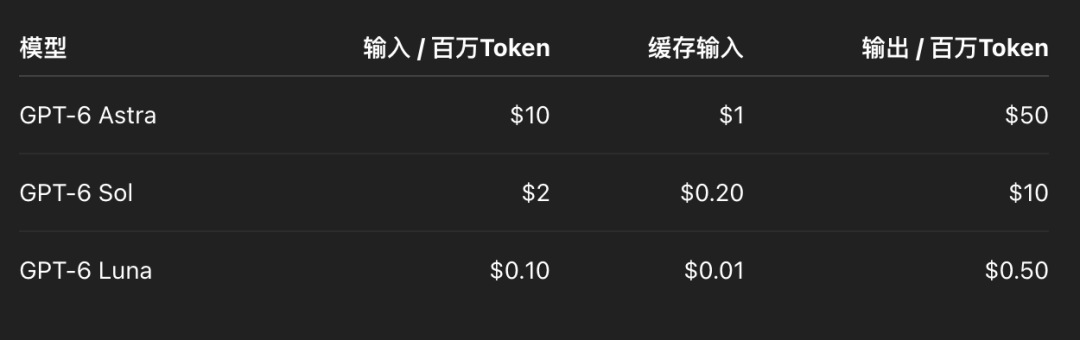
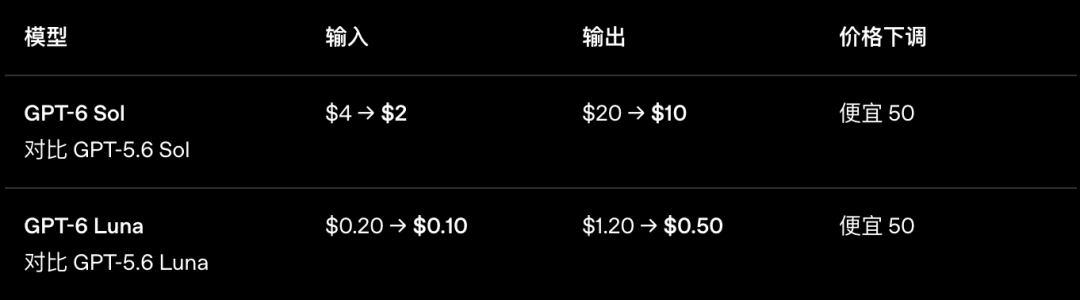
Sol和Luna,比GPT-5.6的同款模型,还要便宜50%。
最离谱的是这个Luna,如果我们单看输入和输出价格,其实已经比Deepseek还要便宜了。
当然我们都知道,真正的大头其实是缓存,嗯,可以看到这个缓存的价格还是要比Deepseek高了3倍左右。
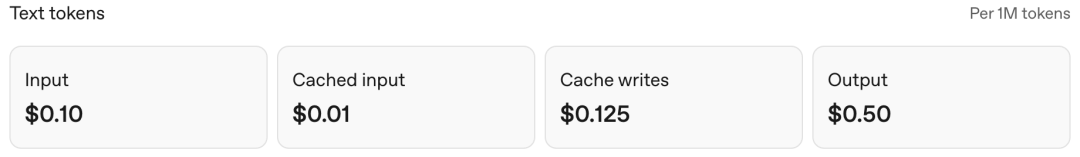
不过Luna最适用的场景,我觉得其实是各种应用背后的自动化任务,就像我的AIHOT背后挂着的十几个需要大模型的信息处理任务一样,每天请求都是上万次。
这种场景下,其实缓存有时候的命中率不是特别高,综合来看能到30%就不错了,那在我看来,Luna的优势就会变得比较明显了。
其他的基本信息如下。
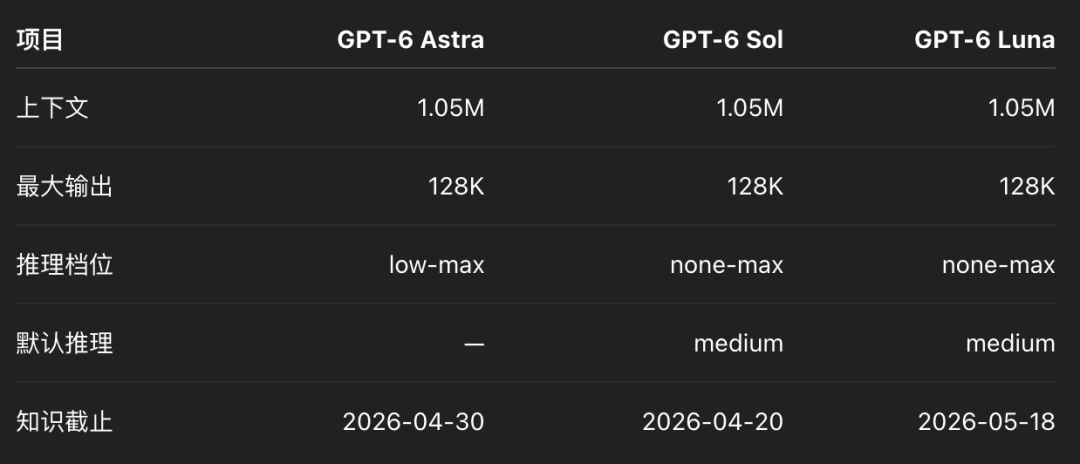
这些知识截止日期居然都不一样。
Luna最新,到了5月18号。
然后就是大家最关心的GPT-6 Sol了,坦率的讲,在能力上,比我预期的会差一些,但是在成本的降幅上,又比我预期的强一些。
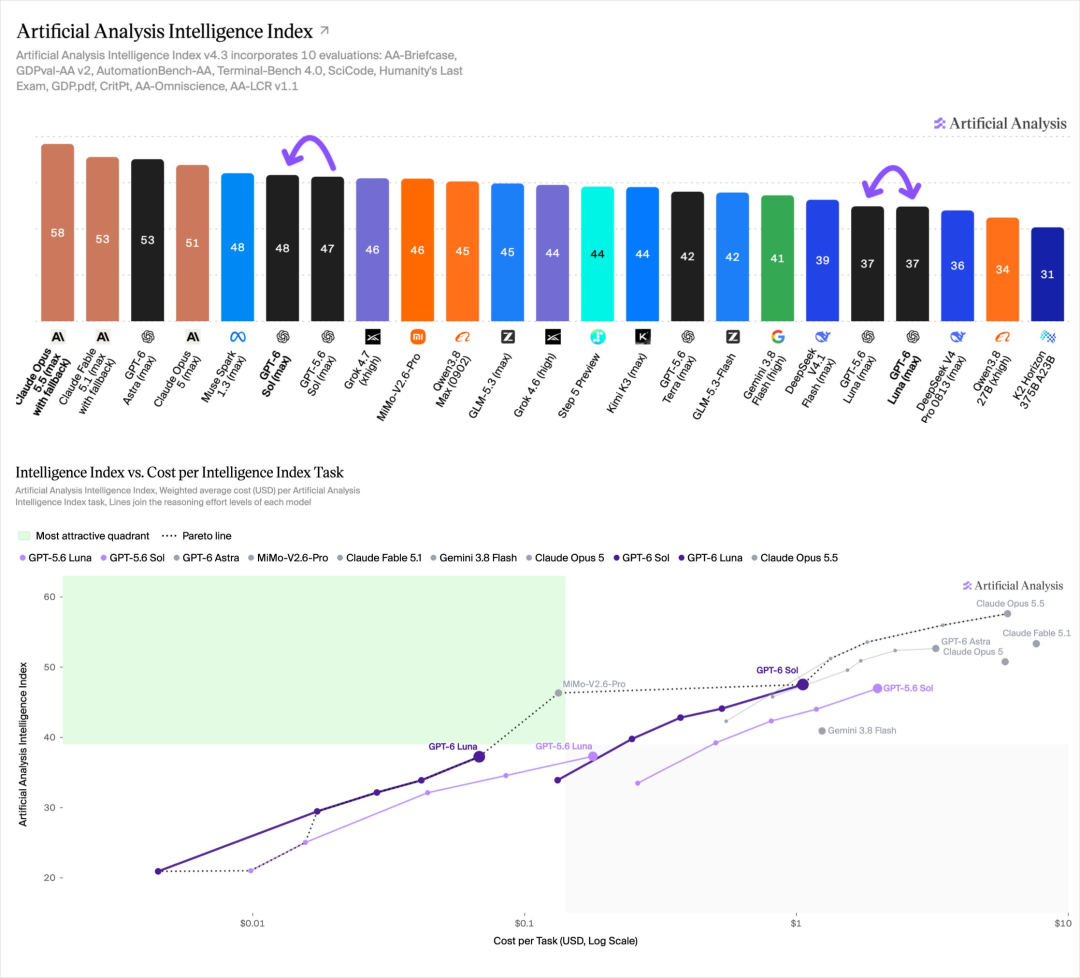
可以看到,在AA上,它只比GPT-5.6 Sol强了一点,但是Opus 5.5,是直接断崖式拿下了第一。
虽然说AA现在的基准有的时候也被很多人诟病,在很多的细节上没有那么准,但是大的方向不会差特别多。
所以GPT-6 Sol更多的还是基于新模型新架构,尽量保持比GPT-5.6 Sol好一点,然后大幅度降成本。
比如这个AutomationBench,就是在上面我们说Claude的时候,比Claude那边要强的那个基准,这个Benchmark测的是Agent跨47种工具,去执行销售、营销、运营、客服、财务、HR这些真实业务流程。
GPT-6 Sol xhigh:
33.2%。
每个任务平均成本:
0.27美元。
GPT-6 Astra low是30.3%,但是任务成本是Sol的3.9倍。
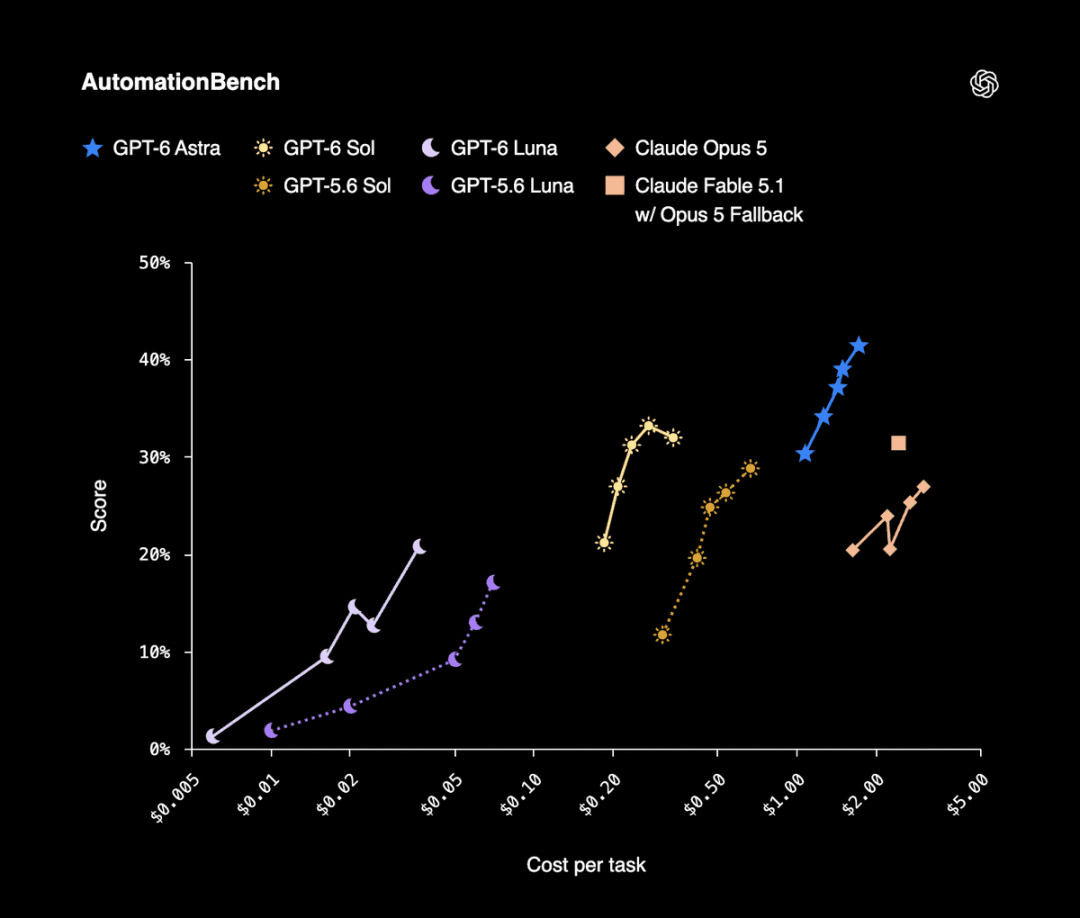
Fable 5.1加Opus 5 fallback是31.4%,成本至少是Sol的8.9倍。
注意这里对比的还是Claude Opus 5,因为Opus 5.5跟GPT-6 Sol几乎同一时间发布,所以OpenAI的图里根本来不及放进去,放进去,其实也不是很好看,对于OpenAI来说不是很有利。
但是这张图已经非常清楚地解释了Sol的定位。
不过GPT的强悍就在于它的Token效率实在是太离谱了,说是省钱,那是真的能省下来。
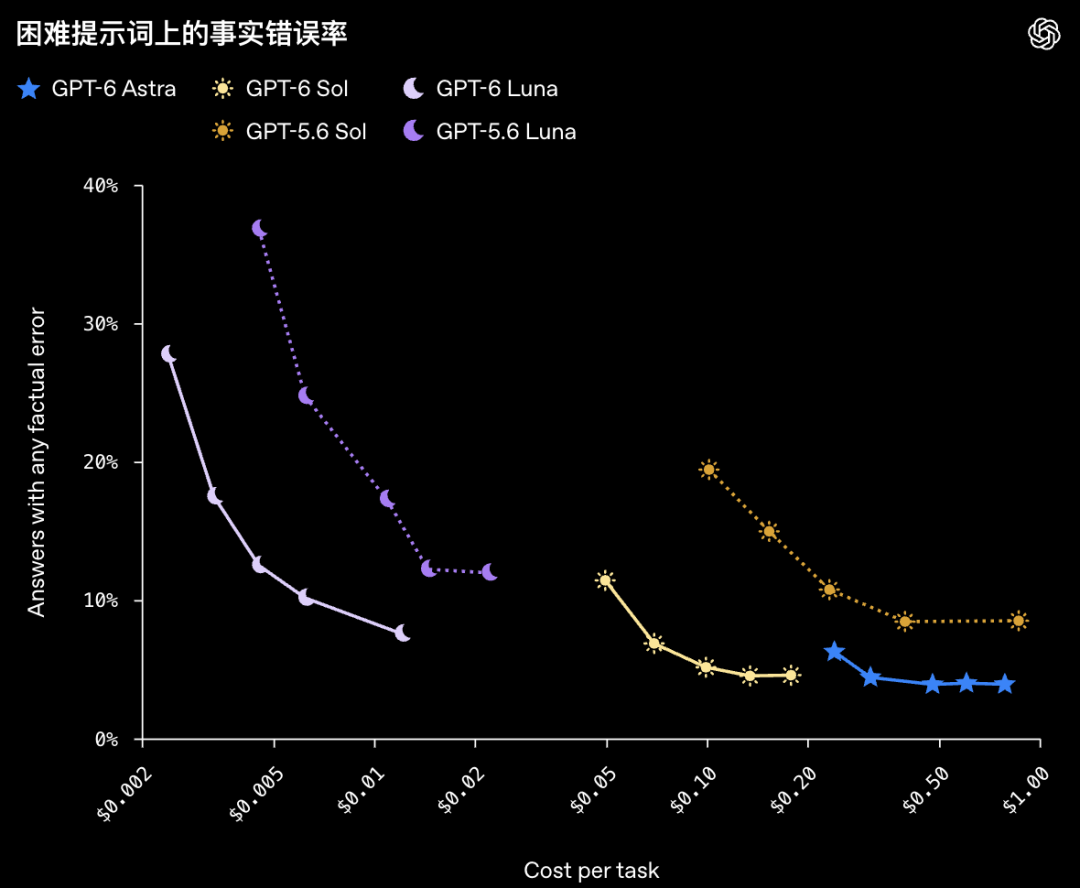
而且这一次相比于之前,有一个我觉得很棒的更新点,就还是事实错误率,我自己一直说,GPT都快成为我的事实核查器了,就是它是真的几乎没什么幻觉,在这个点上还是太强了,过去我一直觉得5.6已经很不错了,那这一次他们又进行了大幅的优化,基本都已经处于GPT-6 Astra的级别了,在这里其实也可以看到推理等级,如果你开的是轻度或者是中的话,很多时候会犯一些事实错误的,这也是为什么我一直推荐大家在日常里面开的是高,甚至如果你是Luna,你得开最高才可以。
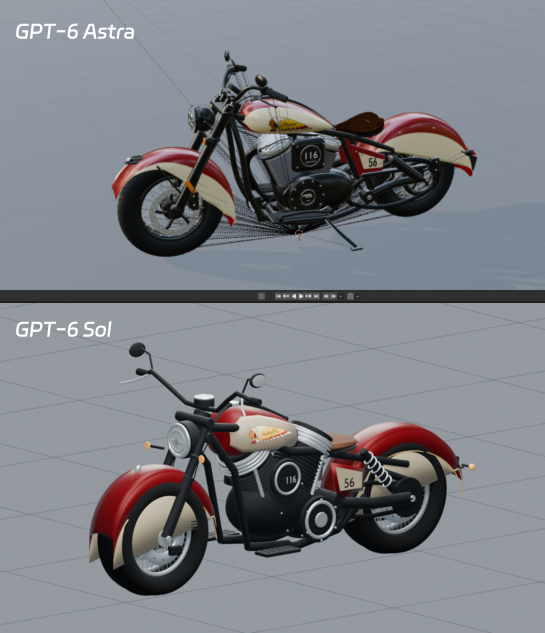
然后我自己也实测了一下,在审美和一些细节上,是有明显降级的。
比如操控Blender建摩托车,这个就能看到,在细节的完成度上,是差的非常远的。
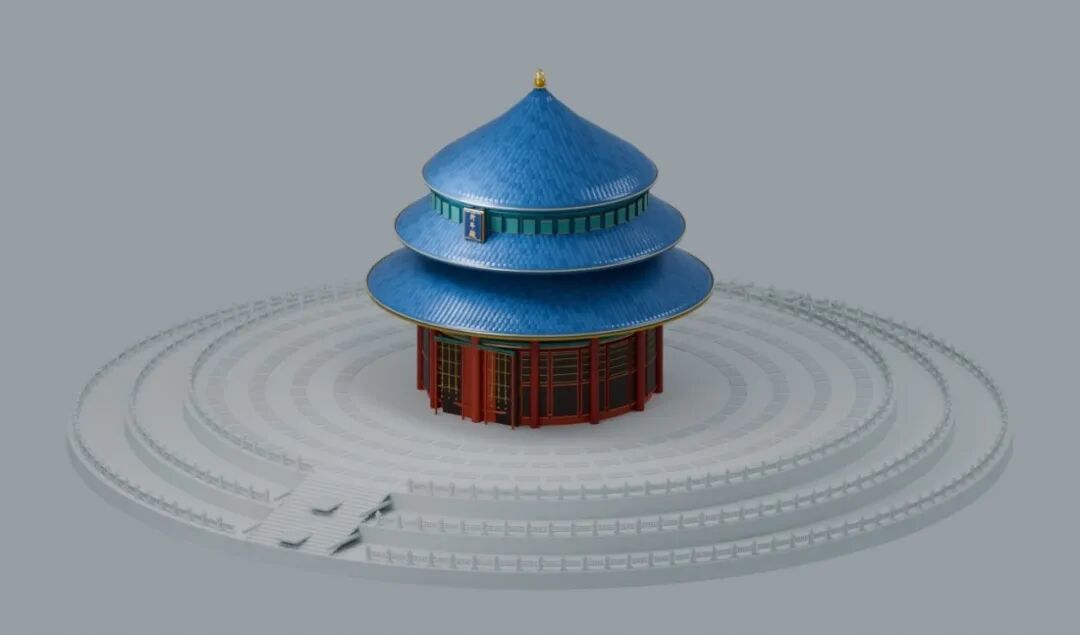
这是GPT-6 Astra的天坛。
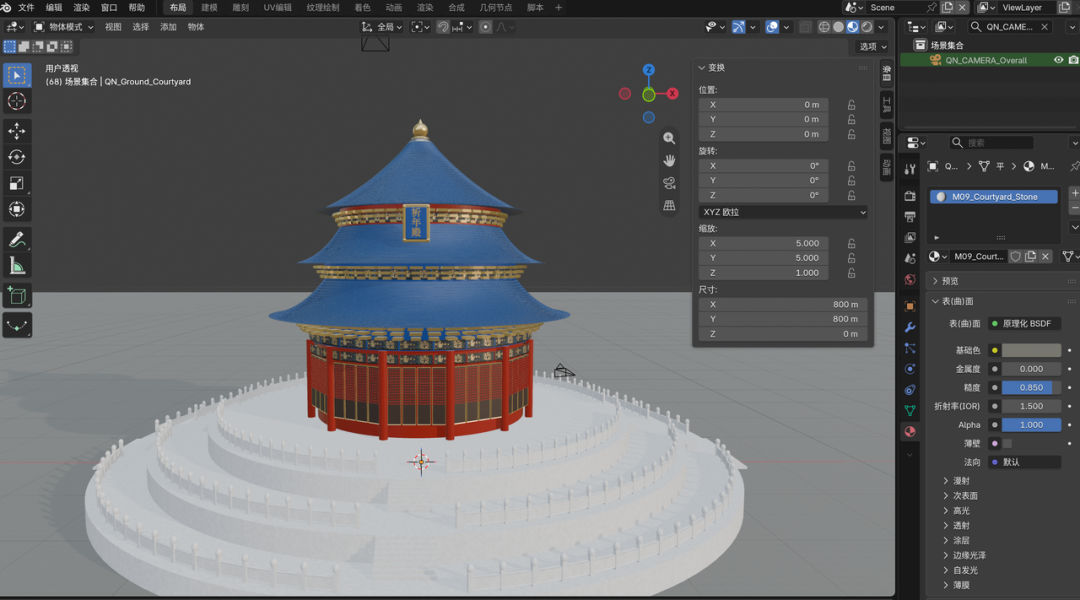
而这,是GPT-6 Sol的天坛,很多细节都是有问题的,门直接就出bug了。
但是成本上,大概降了70%,所以整体也可以接受吧。
我写稿的时候,GPT-6 Sol和GPT-6 Luna已经开始在ChatGPT Work和Codex推送。
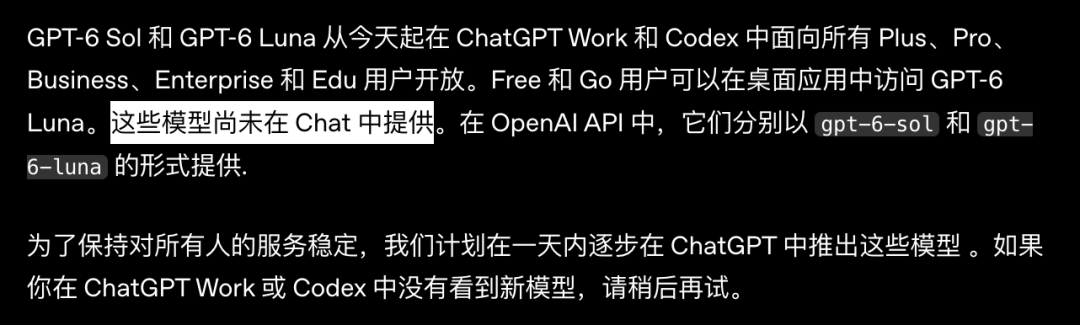
但是比较尴尬的是,OpenAI居然说这些模型尚未在Chat上提供,也就是说,聊天模式下,还是给大家提供的是GPT-5.6 Sol。
这一块是我有点不理解的,明明你的成本都已经大幅下降了,那你为什么不在聊天上面也给大家换成本更低的模型呢?
写在最后
我知道,大家看到这里,最后肯定还是会问一个问题。
所以到底我要怎么选?
现在模型实在是太多太多太多太多了,每天都有新模型发,真的好累啊。
我只能说,尽可能的给大家描述我的选择。
1. 如果你可以订阅Claude不会被封号。
从情理上来说,我真的很讨厌Anthropic这个XX公司。但是从用户体验角度来说,如果你可以订阅Claude,且不会被封号,能长久使用。我还是推荐你订阅Claude。
复杂规划和计划使用Claude Fable 5.1去做,任务执行用Opus 5.5,这可能是目前确实是最好的组合。
2. 如果你被Claude封号,但可以订阅海外模型。
那就无脑订阅ChatGPT,GPT在模型层面,坦诚地讲,还是比claude要差那么一小截,无论是创作,还是认知洞察,还是coding。
但它有几乎最好的C端体验,有无限额度的聊天模式,有最好用的客户端Codex,并且GPT-6在这个世界上还是T0级别的强。
复杂规划和计划使用GPT-6 Astra或者邪修GPT-6 Pro去做,使用GPT-6 Astra high或者GPT-5.6 Sol xhigh去执行,GPT-6 luna用来跑大规模的批量自动化任务,会非常的香。
3. 如果你只能订阅国产模型。
坦率的讲,Qwen、Kimi、GLM、MiMo、DeepSeek这几家,都没有那种说断代的区别,用的习惯哪家就用哪家吧,唯一麻烦的是模型梯队没有那两家强,Kimi K3和Qwen 3.8 Max更加适合做规划和方案,GLM-5.3和Mimo v2.6 Pro、DeepSeek V4.1 Flash更加适合做执行。
只是谨记,永远只订阅1个月就行,不要太长,最多买季卡,千万不要买年卡。
OpenAI和Anthropic还是太成熟了,现在的环境跟之前还不太一样。
以前呢,是这两家负责做前沿的智能上线,换句话说,就是做高端。
然后呢,国产模型来去做中端和性价比。
但是现在,人家供应链好像更加成熟了,就跟苹果一样,也开始全域通吃,你的中端,甚至你的超低端,我全都要。
不过,对于所有用户来说,这也是一种好事吧。
因为现在的智能终于好像变得越来越便宜了。
过去我们同等的AI性能,它的成本几乎是每季度会下降47%,智能,再过几个月到半年时间,它可能真的就会像煤水电一样,成为每一个人都能用得起的资产。
那时候,可能就是真正的,大繁荣时代了。
免责声明:本文章仅代表作者个人观点,不代表本平台的立场和观点。本文章仅供信息分享,不构成对任何人的任何投资建议。用户与作者之间的任何争议,与本平台无关。如网页中刊载的文章或图片涉及侵权,请提供相关的权利证明和身份证明发送邮件到support@aicoin.com,本平台相关工作人员将会进行核查。


