今天凌晨,真的又是一个神奇的一天。
两个模型,直接在今天凌晨同时发布,中路对狙。
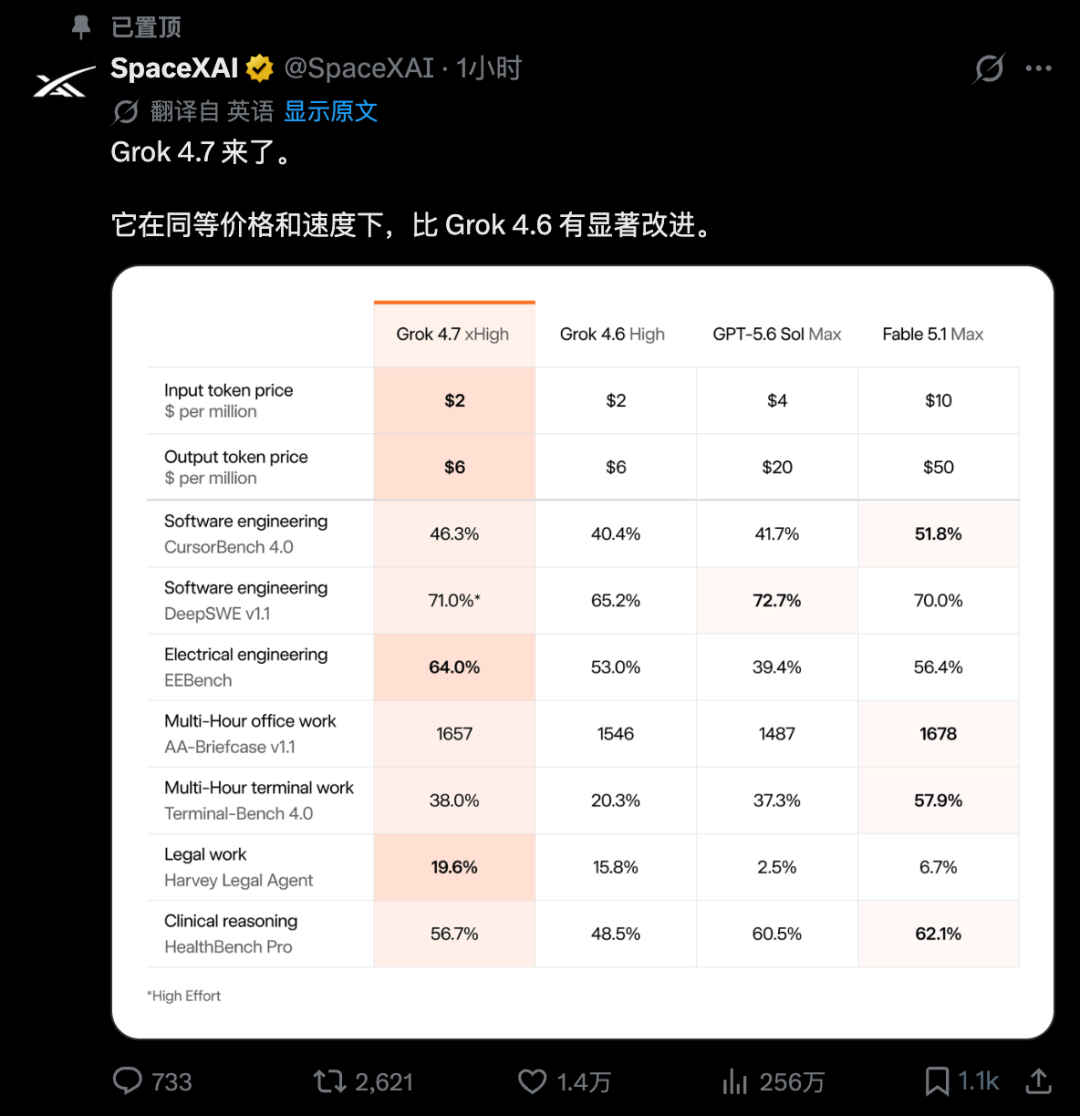
一个是延迟了两周,终于出来见人的Grok 4.7。
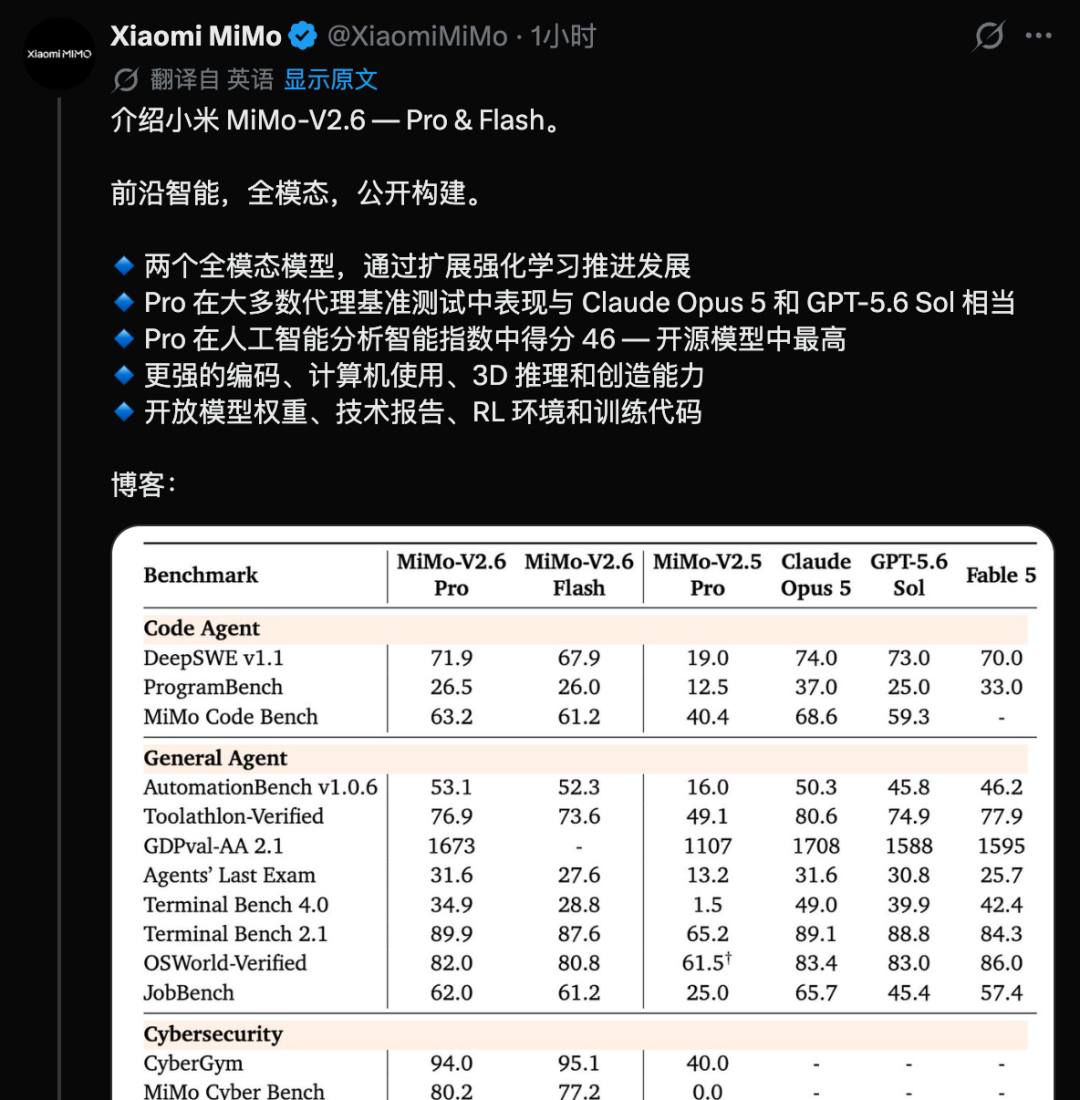
一个是小米,在前几天的模型训练直播后,终于掏出了他们的MiMo v2.6。
各领风骚十几天,真的不是说说而已。
曾经我说过,大模型在我心里,其实存在一个很难同时满足的不可能三角。
性能、价格、速度。
这就是过去几乎满足不了的不可能三角。
最近GPT-6 Astra应该非常能让大家感受到这种感受了,强是真的强,直接重构了我的很多基建,只要设定好目标,就是你最强的执行工具人。
但是贵也是真贵,慢也是真慢。
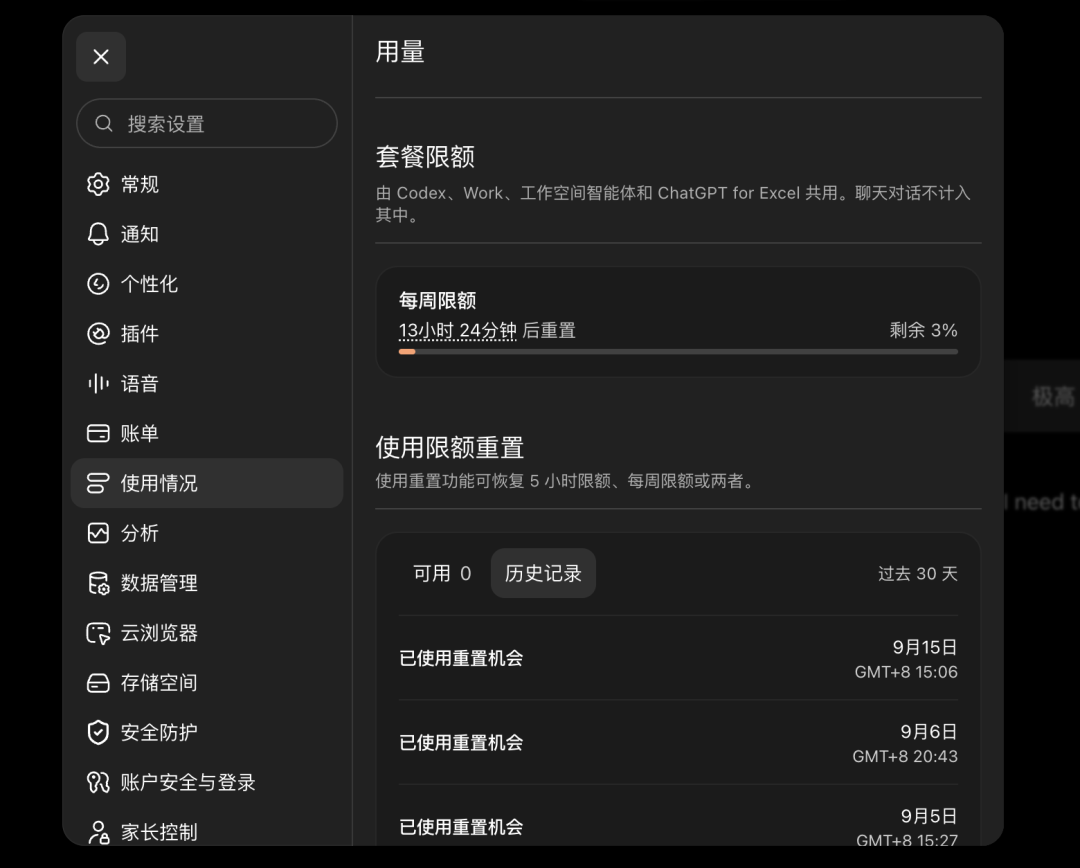
我前几天重构底层架构和数据库的时候,几乎一天一个200刀的额度,3个账号轮流干,加上之前送的重置卡,才勉强顶住,后面用了GPT-6 pro+MCP大法,以及部分小任务都降级到GPT-6 Astra low去做,后面才长久了一点,但是还是不太敢放肆用,因为真的贵。
就像这个账号,剩最后3%,我都不敢用。
所以,过去我一直觉得,Grok 4.6刚刚出的时候,我就觉得,他是我心中最符合的,满足我心中这个不可能三角的模型,虽然开发能力上,确实没有那么强,但是在当时,速度还真不错也不贵,所以到后来我也一直常用,因为我真的受不了GPT-5.6 Sol的龟速。
所以我心中是对Grok 4.7有很大的预期的,我希望他能把这个不可能三角,再往上抬一步,因为老马说。
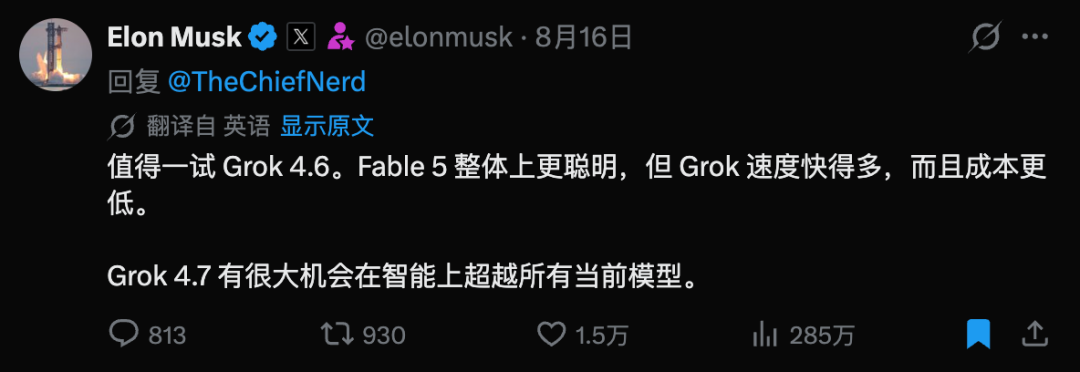
虽然后面又自己打自己脸。。。
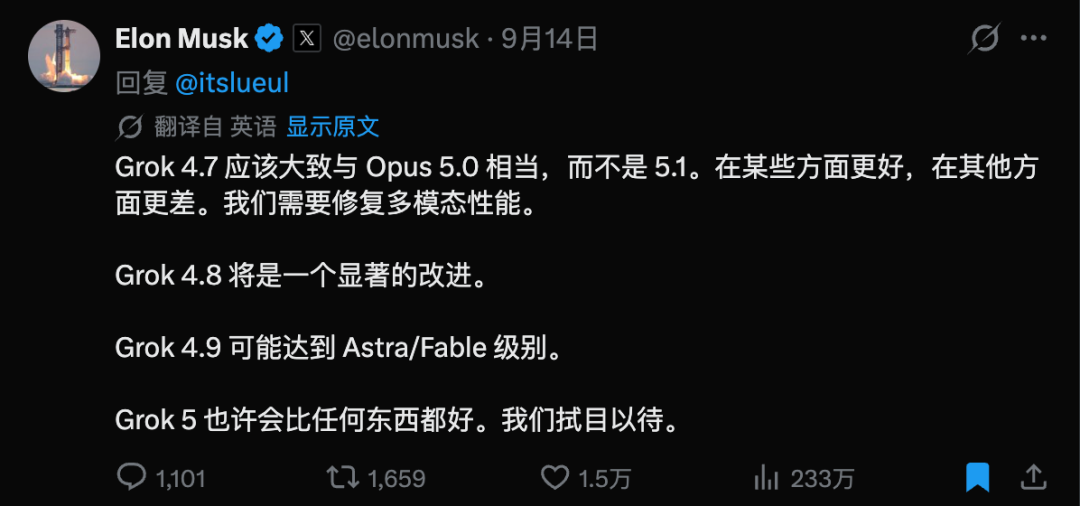
然后今天,Grok 4.7终于上了,但是讲道理,在看完以及测试之后,其实是有点低于我预期的,而且在他发布的3个半小时,MiMo V2.6深夜发布,这玩意反而超了我预期,几乎成为了我现在觉得,目前时间段里,解决不可能三角的版本答案,两个直接形成了鲜明的对比。
这画面,一下子就尴尬了起来。
一. Grok 4.7
先还是聊聊Grok 4.7吧,虽然感觉有点拉了,但是还是简单说一下。
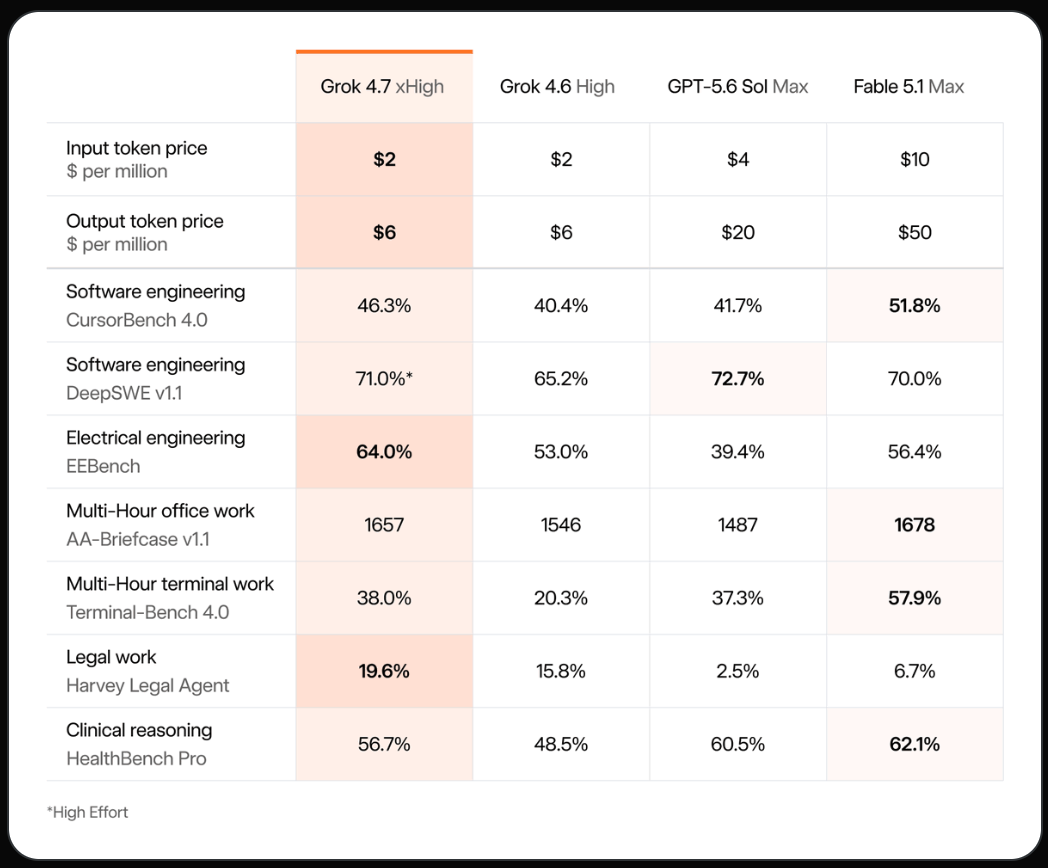
他们内部的跑分我其实都有点不太想放了,但是还是放一下吧。
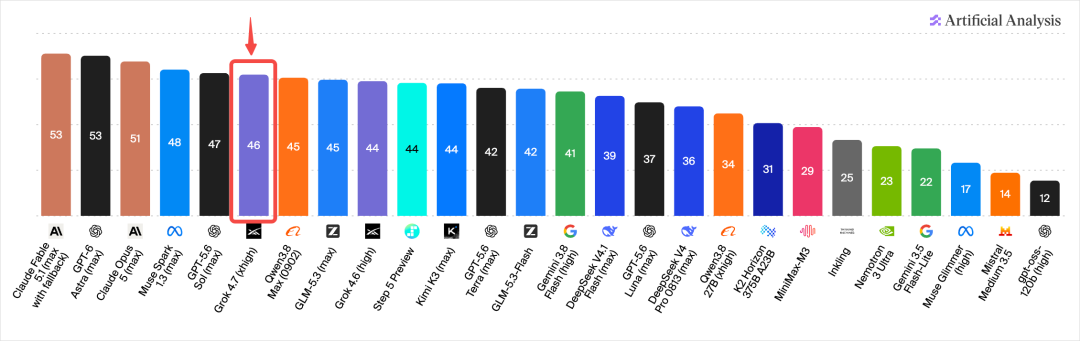
但是如果我们看AA指数的话,46分,跟GPT-5.6 Sol差不多。
这个模型,按他们的话说,是一个2.1T的全新预训练的模型,比Grok 4.6要大不少,Grok 4.6是个1.5T的,但是还是没解决上下文的问题,只有500K,没有1M上下文。
并且说加了SpaceX多年积累的工程数据在里面训,结果出来的效果,其实感觉一般。
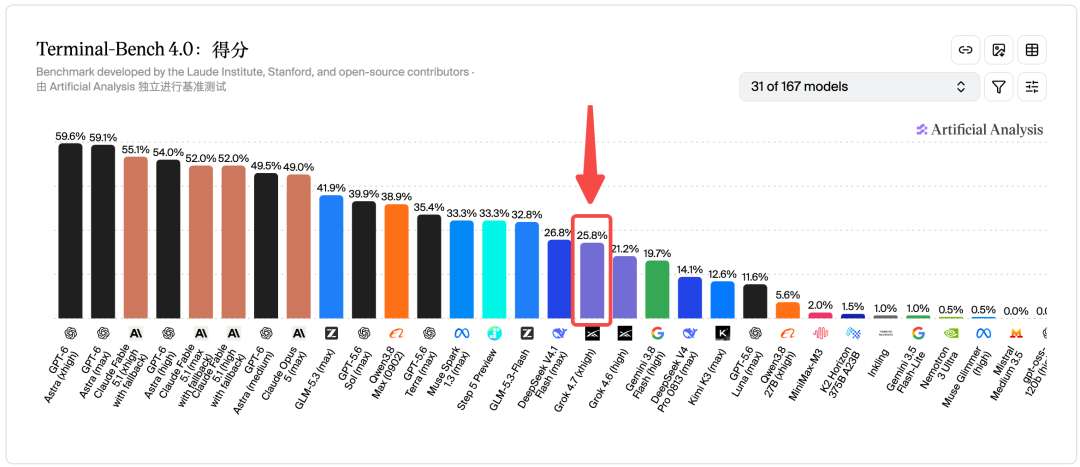
在当今几乎是最权威的Coding Agent评测集Terminal-Bench 4.0上面,AA自己去跑,Grok 4.7的得分,真的有点惨不忍睹了,甚至跟DeepSeek V4.1 Flash是平齐的,连GLM 5.3 Flash都没比过,更别提前面的GPT-6、Fable 5.1这种怪物了。
在我比较常看的评估模型前沿科研推理能力上的CritPt上,相比于Grok 4.6,几乎没啥进步,着实一般。
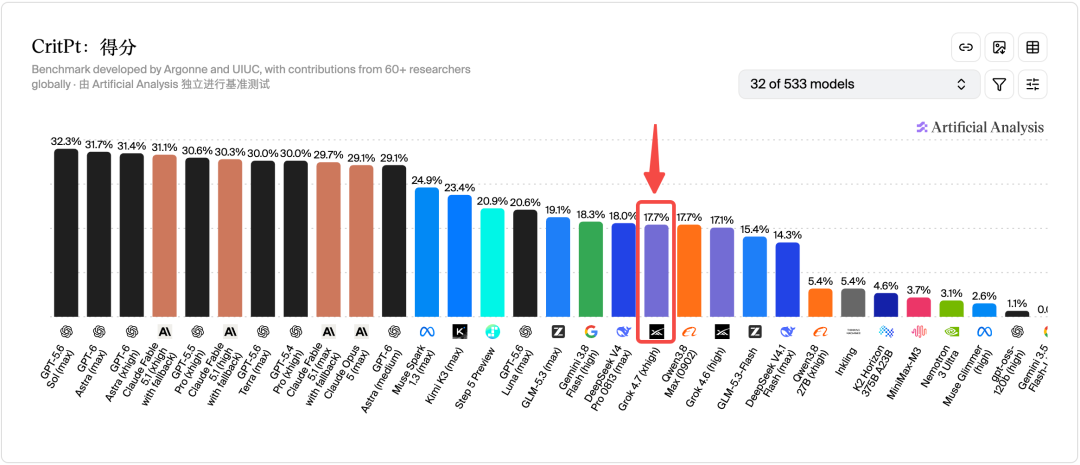
整体上还是因为在一些知识工作,比如法律等上面,效果还不错,帮他们把总分给拉上去了,要不然就这个Coding和Agent水平,这个AA的总分肯定好看不了。。。
然后,在前端层面,崩盘了,我甚至觉得还不如Grok 4.6。。。
这是GPT-6 Astra的鹈鹕骑车。
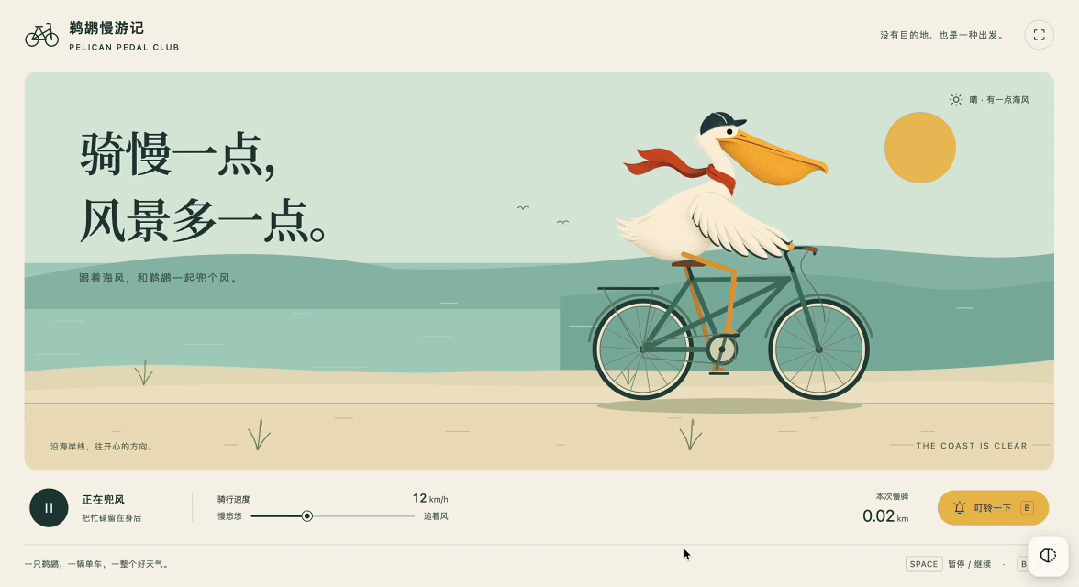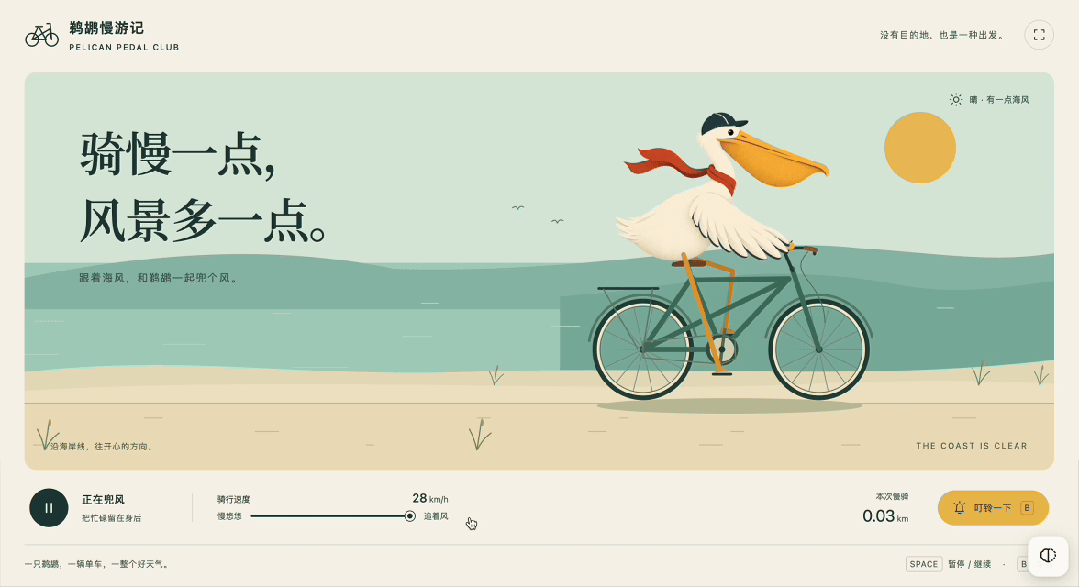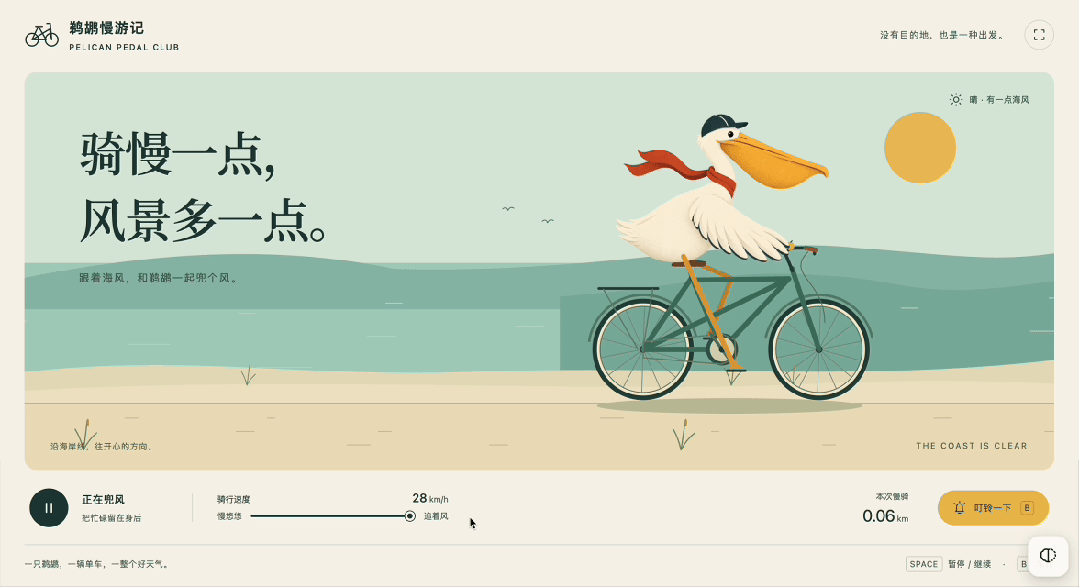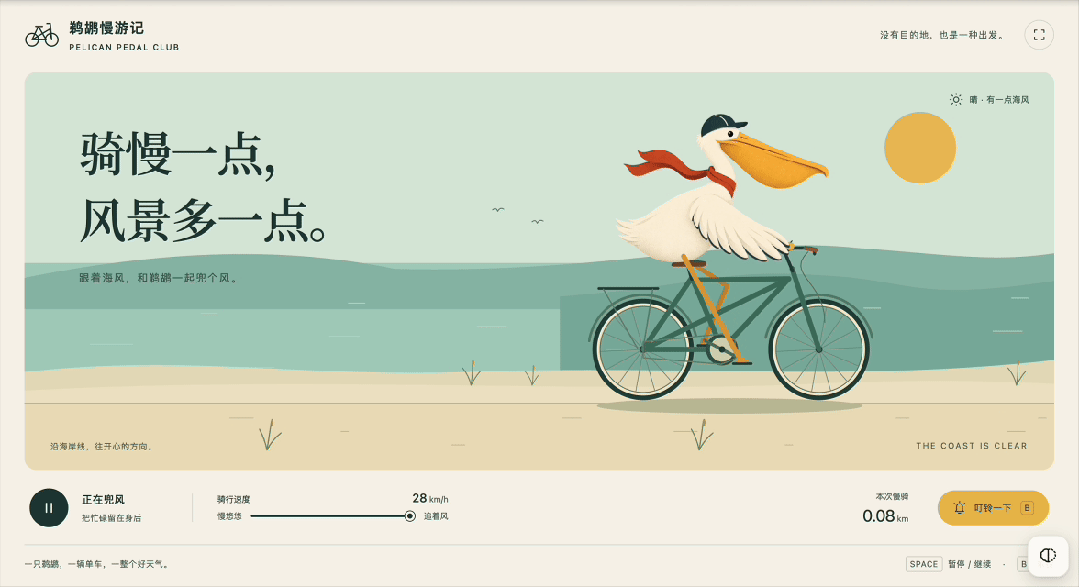
然后...这是Grok 4.7的。。。
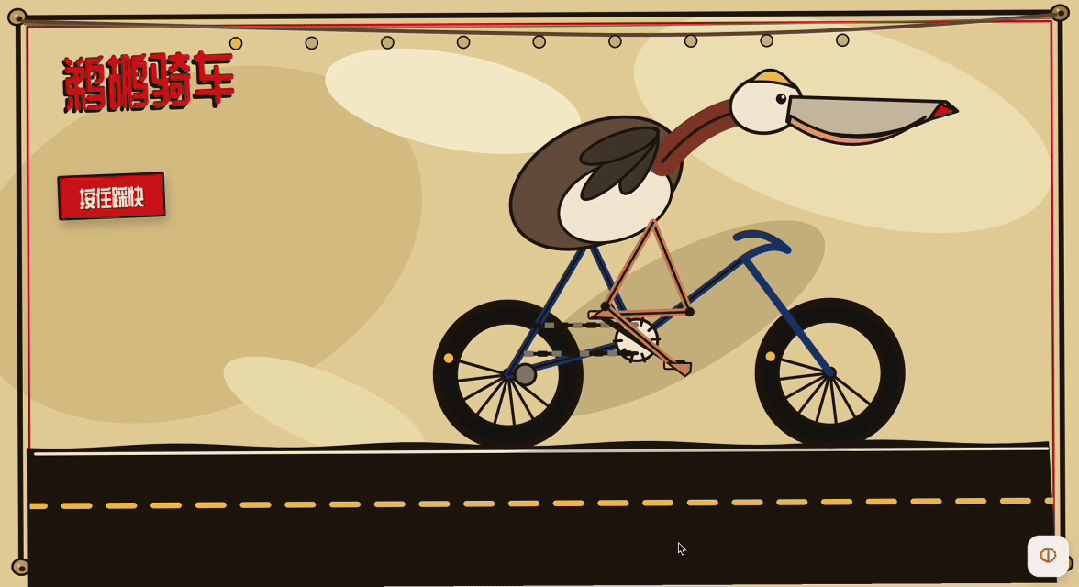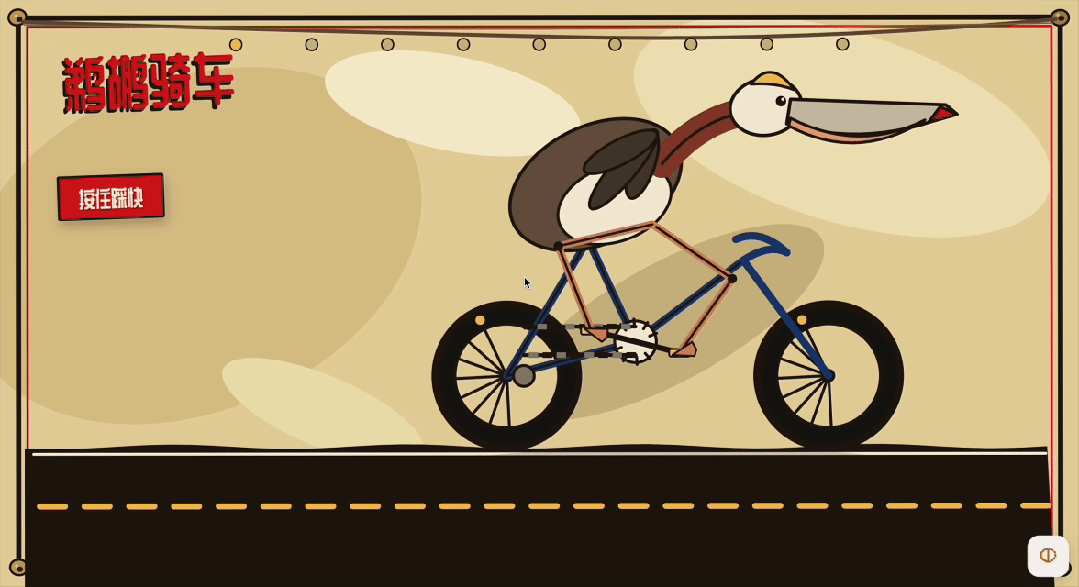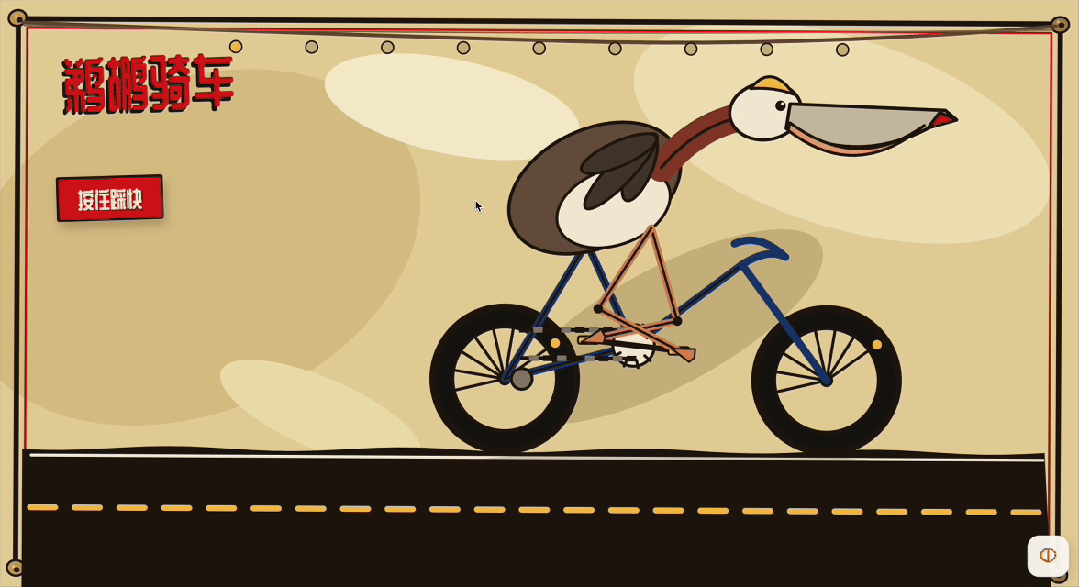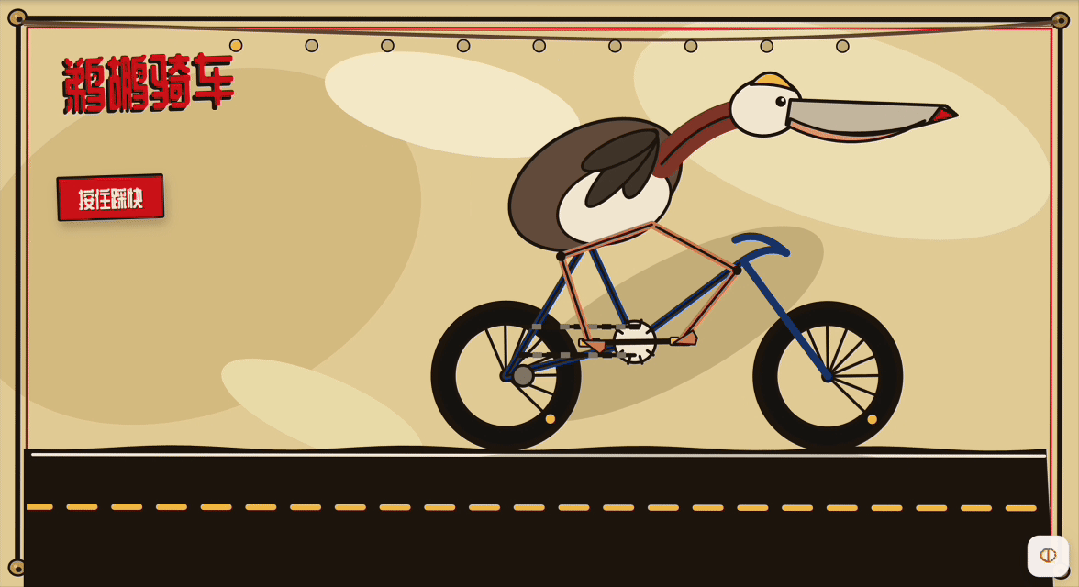
???
我也不知道出了什么问题。
然后在我们建筑前端设计+性能测试上,设计密度不够,并且性能优化有很大问题,极其卡顿,甚至在性能流畅度上,远不如用GLM 5.3 Flash开发的效果。
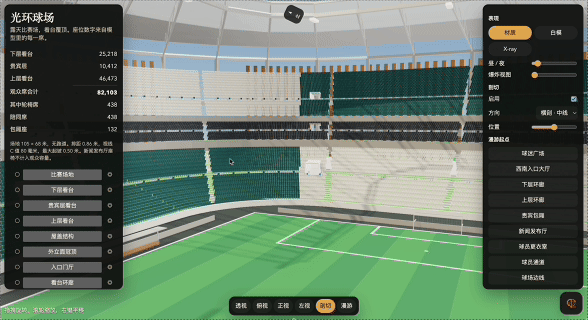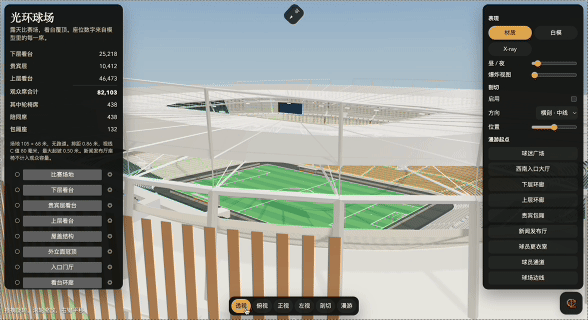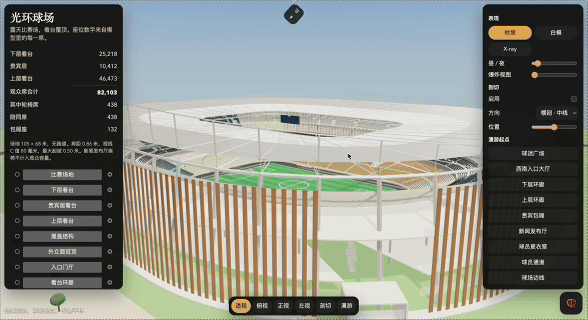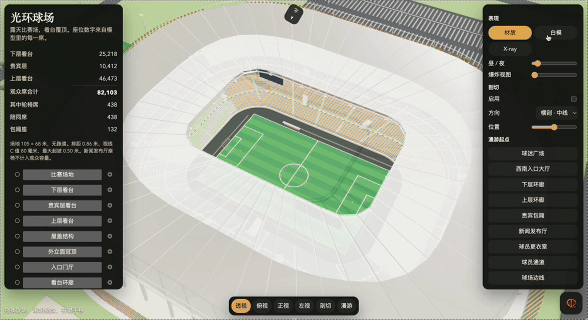
虽然价格没变,跟Grok 4.6一样,都是百万输入Token 2美元、输出Token 6美元,但是这个进步,属实有点小。
然后今天晚上,如果Grok 4.7自己发了,MiMo没发,大家可能也觉得就还好了,甚至可能都没啥热度。
但是,在Grok 4.7发布3个半小时以后,MiMo v2.6发了。
这个鲜明的对比,一下子让Grok 4.7显得有点小丑了。
二. MiMo-V2.6
坦率的讲,我本来对MiMo不报有啥预期的,因为他们太久太久没动静了,V2.5已经是4月的事了,而现在,已经9月底了。
你很难想象,一个模型厂商,在5个月的时间里,几乎没有新的大模型发布。
但是,今天深夜,MiMo-V2.6终于来了,一共三个版本。
MiMo-V2.6-Pro、MiMo-V2.6-Flash、还有一个20倍速的MiMo-V2.6-Pro-UltraSpeed,目前应该是全球最快的了。
然后,我自己体验完之后,我想说。
这个我本来不报有期待的,却给我了最大的惊喜。
先看跑分。
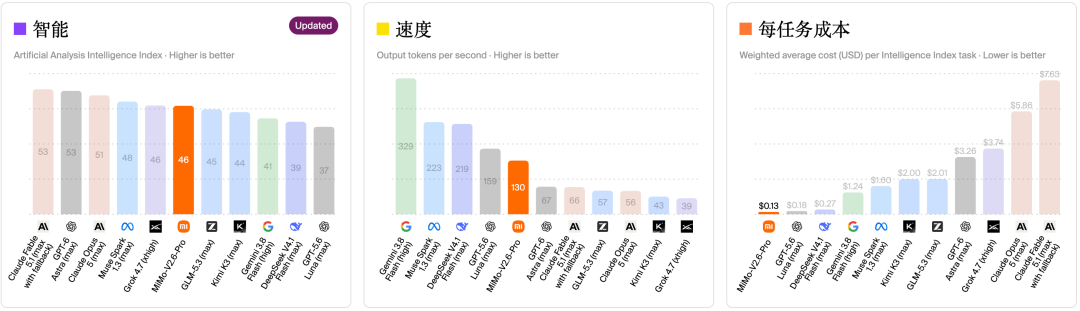
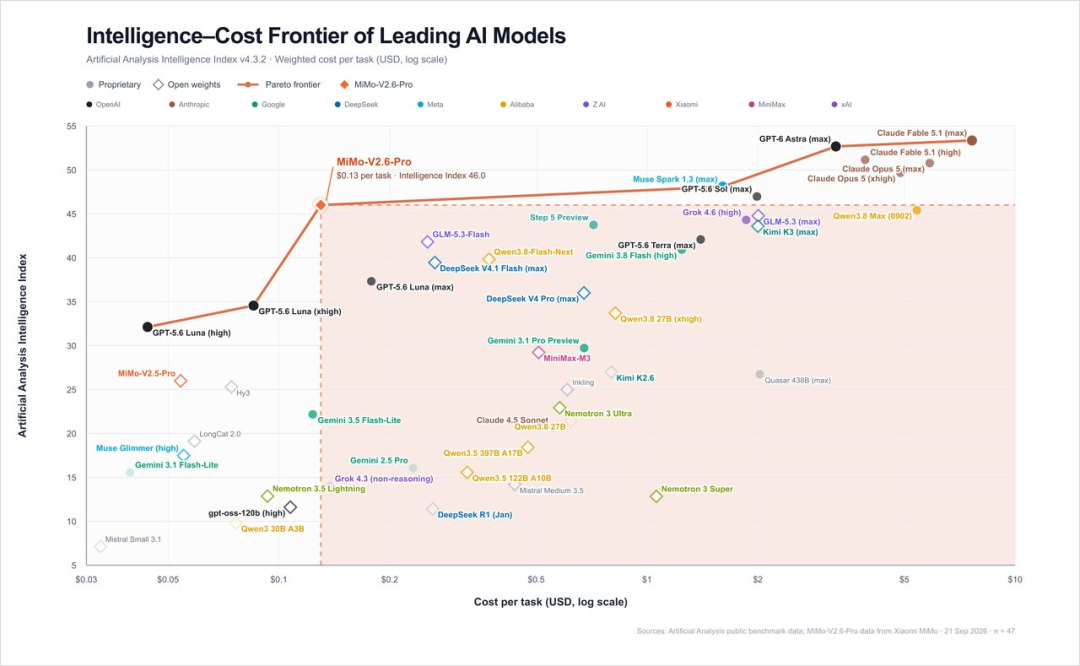
我写这篇稿子的时候,AA上刚刚更新了MiMo-V2.6的成绩。
46分。
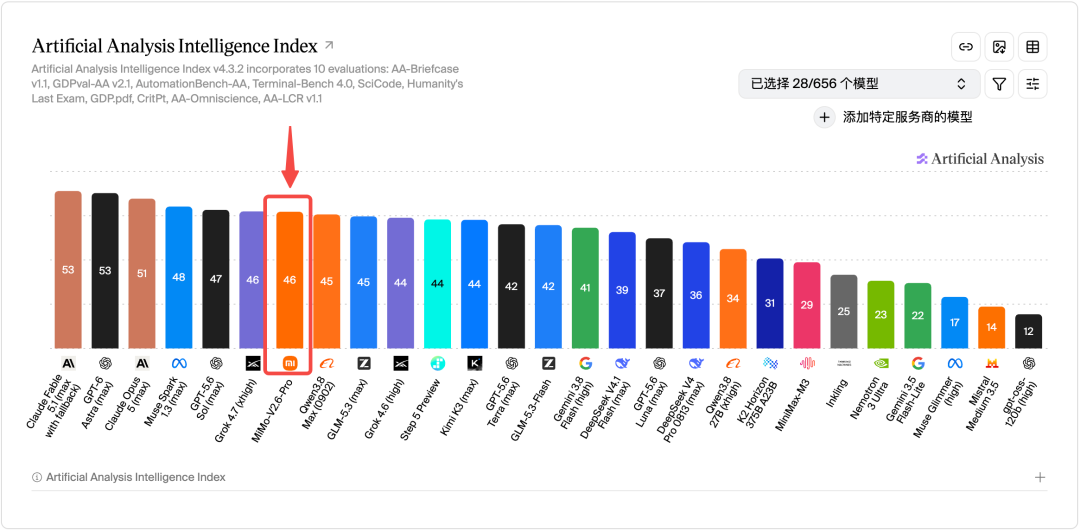
跟Grok 4.7完全打平,位列开源模型第一和国产第一。
虽然不知道这个第一能维持多久,但,MiMo V2.6 Pro,就是当下的第一。
从V2.5的26分,进步到如今V2.6的46分,这个提升,还是挺猛的。
他们所有的细节跑分都在这。
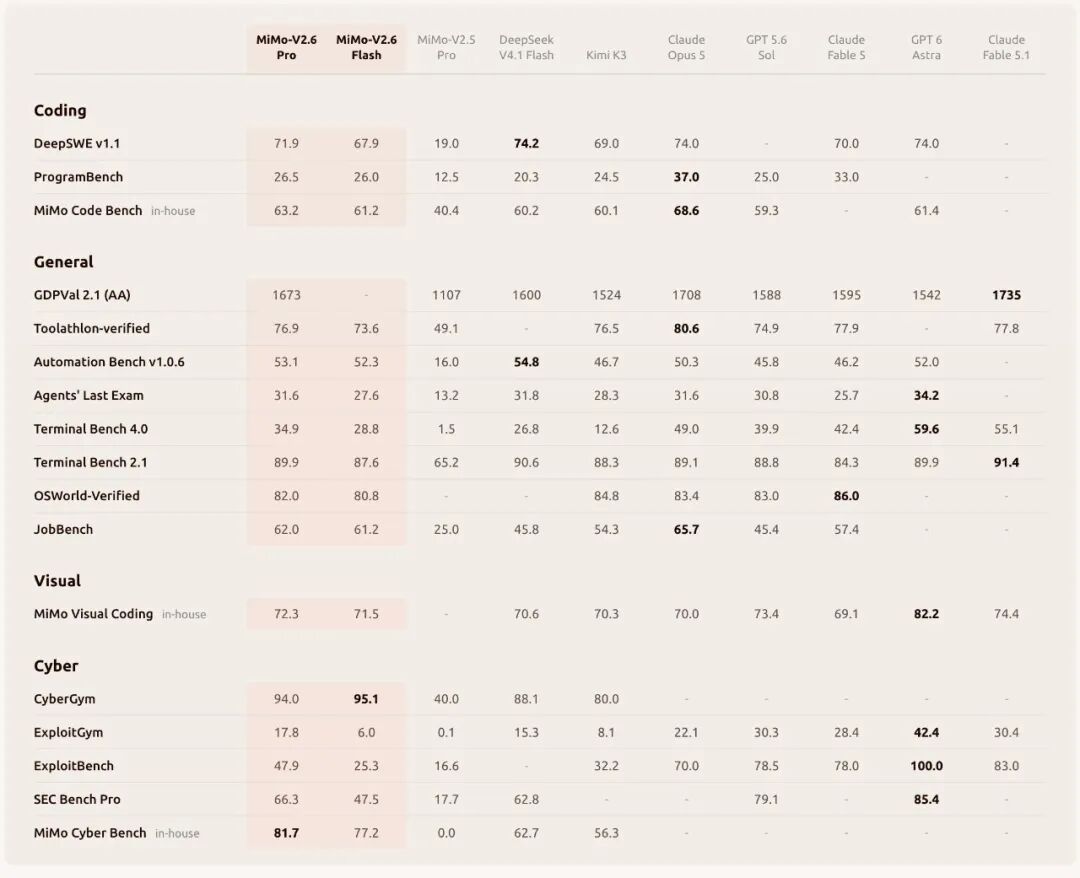
不过这都是他们自己的,看看就行了。
AA上那两个我比较看重的,代表Coding Agent能力的Terminal-Bench 4.0和代表科研推理能力的CritPT,就是刚才Grok 4.7拉完的那两个,MiMo V2.6 Pro是这样的。
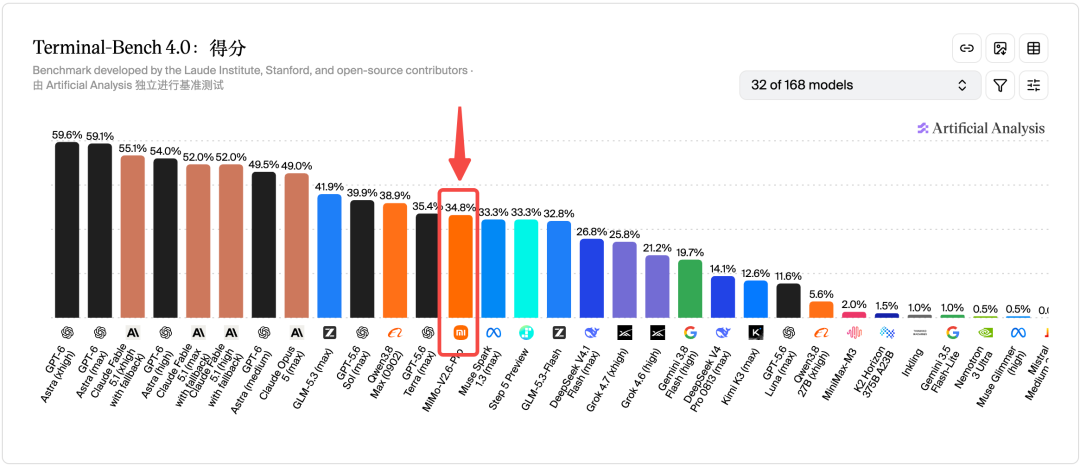
硬核的Coding Agent任务,MiMo在开源模型里面,仅次于GLM-5.3这个究极强化Coding能力的变态,还有刚刚强化过的Qwen 3.8 Max,位列第三。
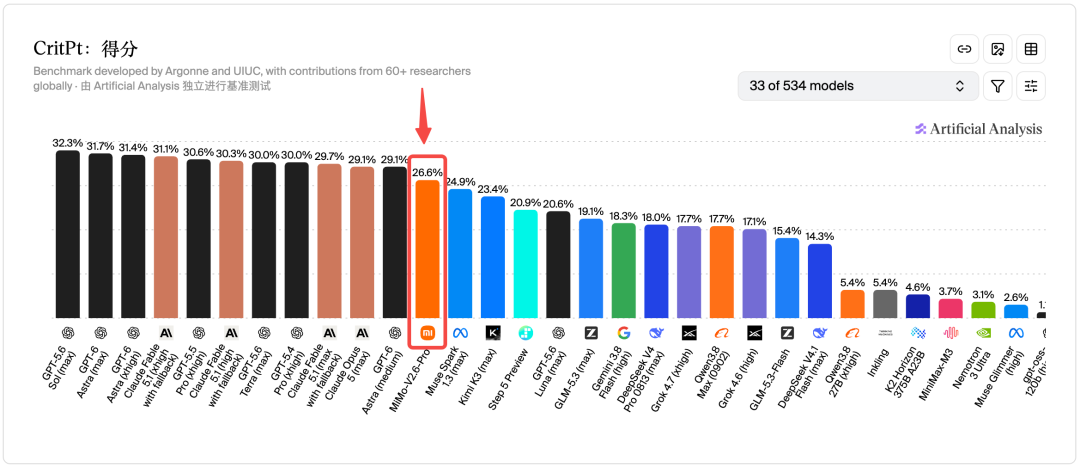
但是在这个CritPt科研推理任务上,MiMo V2.6 Pro居然仅次于GPT和Claude这两个大魔王,成为了得分最高的模型。
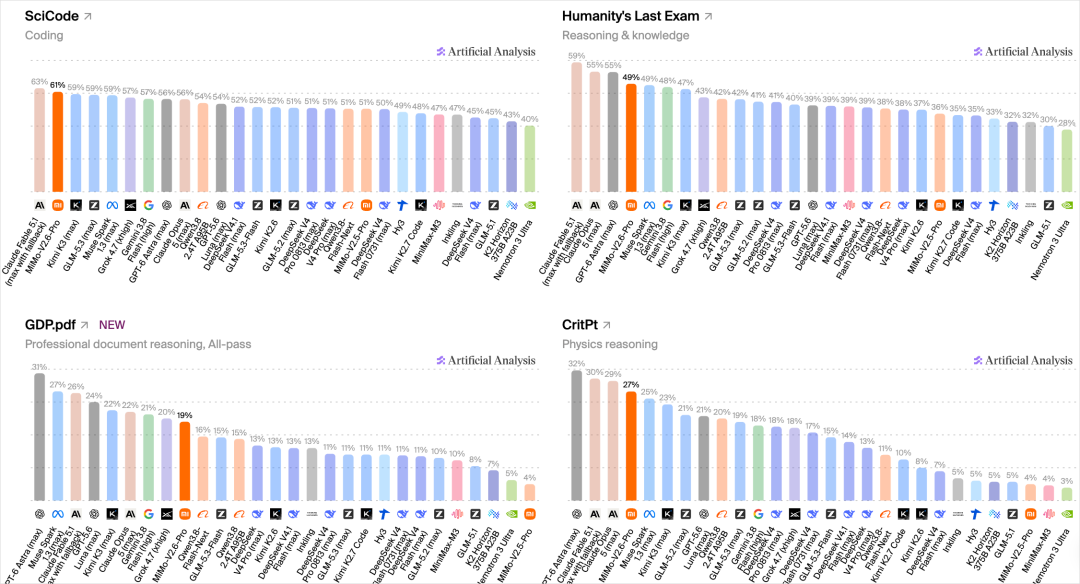
在其他的各项任务上,也基本是在前列。
其次是价格上,MiMo V2.6 Pro,缓存输入每百万Token 0.025元,Flash直接就是0.02了,直接是跟DeepSeek V4.1 Flash对标,而且没有什么优惠期、没有什么闲时价格一说,就是0.025和0.02元,这个价格有多离谱,用AI比较多的同学一定懂的。。。
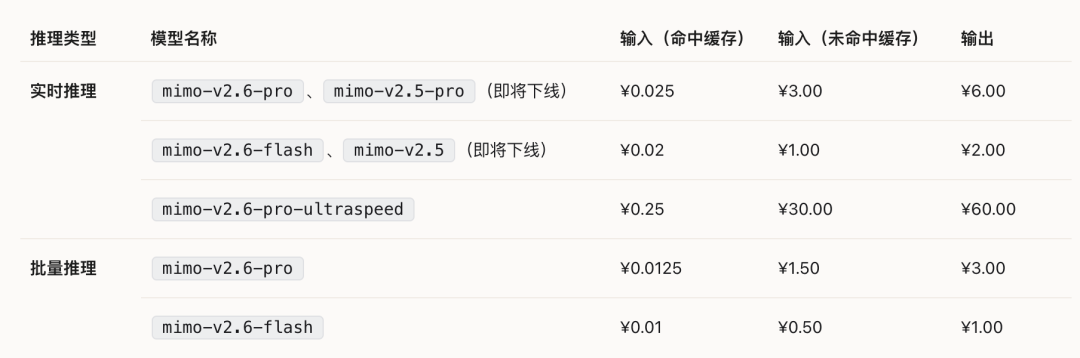
输入和输出价格,也超级低,甚至你用非实时可以等着的批量推理方式,你的价格,还能给你打半折。。。
我把一些主流大模型的价格,都换算成人民币,给大家列了一下,大家就知道,MiMo的价格有多离谱了。
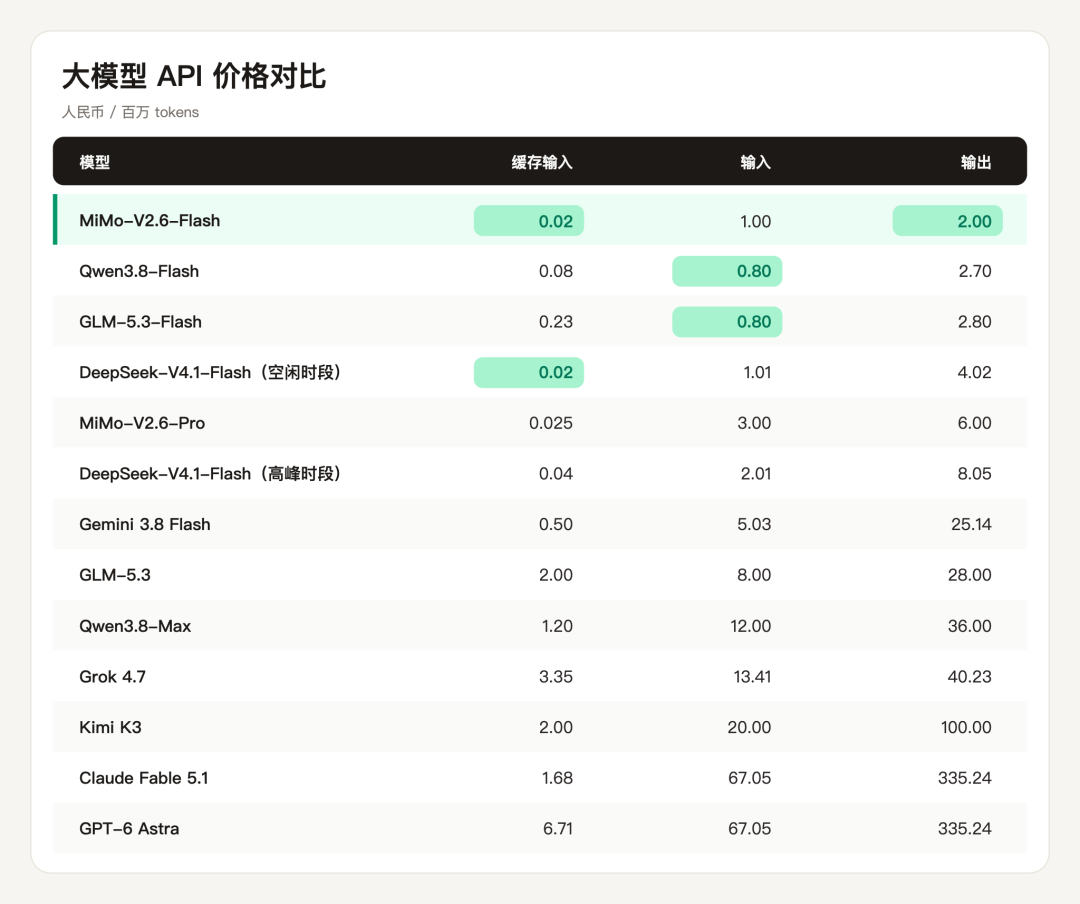
小米真的是价格屠夫,DeepSeek在小米面前,突然都有点不够看了。。。
不仅是智能和价格有优势,这玩意的输出速度,还贼快。。。
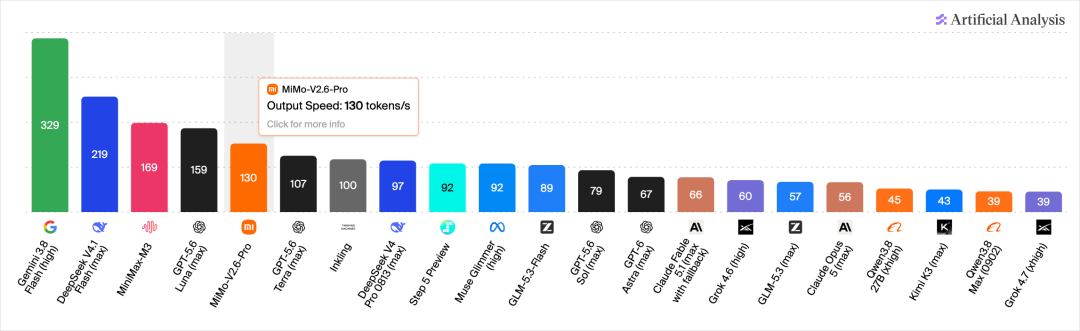
怎么就干到130 Token/s了。。。
所以,当这三个数据摆出来的时候,大家就知道,为啥我说,我心中的不可能三角,在这个版本里,好像是属于MiMo V2.6的了。
我自己内部跑了一下AIHOT精选的小测试,想看看MiMo V2.6 Flash能不能进来,充当我的后端模型。
然后直接跑了2000道题,没想到,MiMo V2.6 Flash品味分第一,速度和价格跟DeepSeek V4.1 Flash打平,给我一下子整不会了。
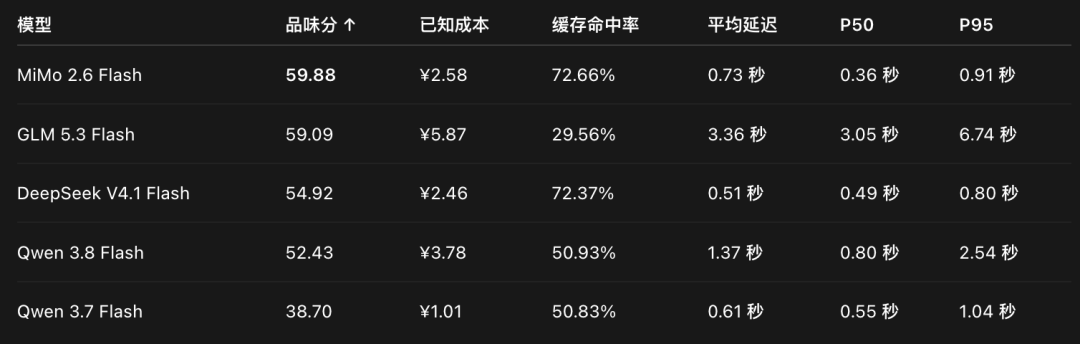
已经正在无脑把AIHOT背后的一些主要的判断API,全面切换到MiMo V2.6 Flash上了。
至此,梁圣降级为梁子,罗圣正式上位。
而大模型斩杀线,也被MiMo V2.6,再次扩大了一步。
小米这次这个模型,做的确实好,是真的好。
MiMo V2.6这一次,其实也并没有把参数规模再疯狂往上堆,基座用的还是V2.5那个。
MiMo-V2.6-Pro总参数1.02T,激活参数42B。
Flash更小点,309B总参数,激活15B。
两个模型都是1M上下文,而且都是原生全模态,文字、图片、视频、音频全部能直接灌进去。
也就是之前的基模没换,通过后训练,直接干到了V2.6的地步。
小米感觉现在也能称为是后训练仙人了。。。
前几天小米也一直在直播一个抽象的东西,确实也是我第一次见。
罗福莉发了个X,然后自己把自己训MiMo V2.6做强化学习的过程直接给公开直播了。
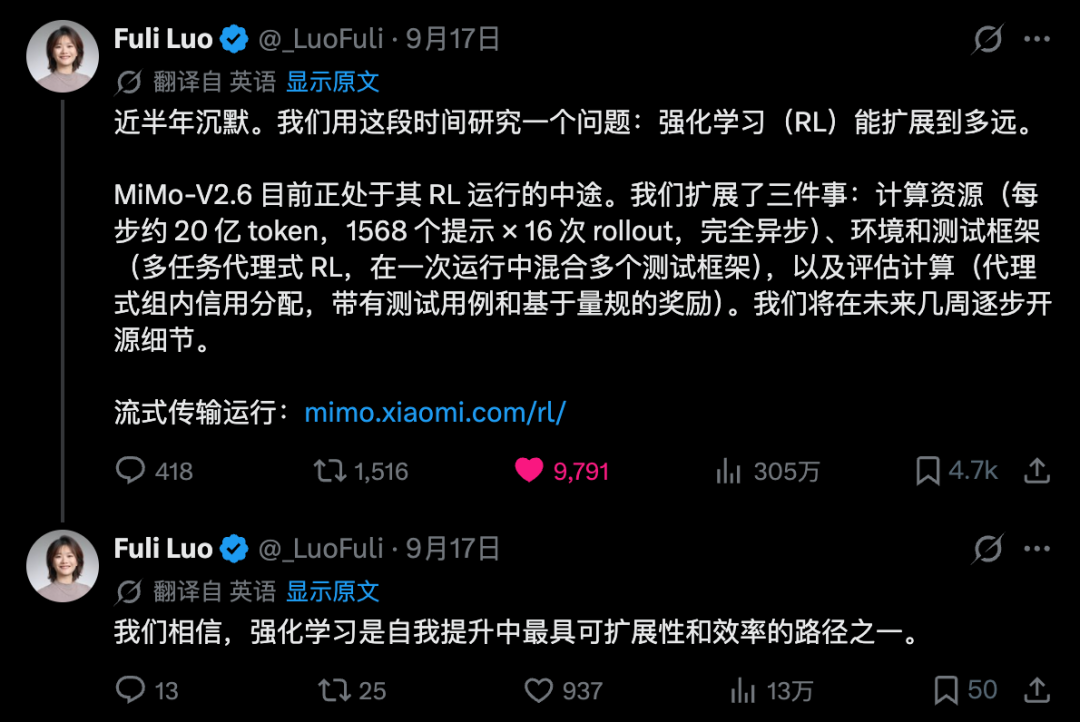
这是一场豪赌,因为,你是完完全全可以在里面,看到所有的指标的。
你可以直接看它现在训练到第几步,可以看到花了多少钱,可以看到每一步跑了多少数据,训练Pass Rate怎么变等等等等。
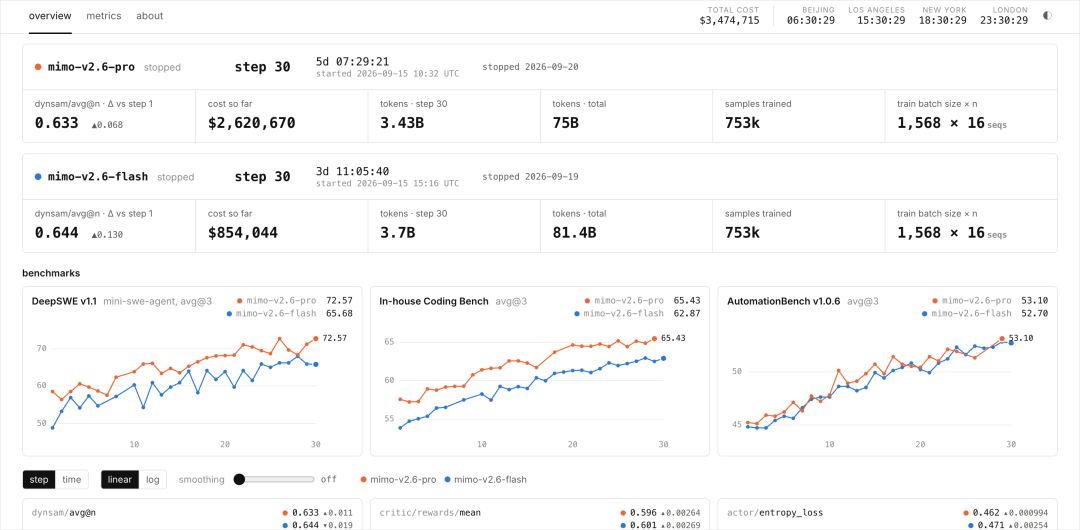
MiMo V2.6 Flash这一轮强化学习,花了大约85万美元。
Pro花了262万美元。
加起来差不多347万美元,也就是人民币两千多万。
就为了这不到6天的后训练。
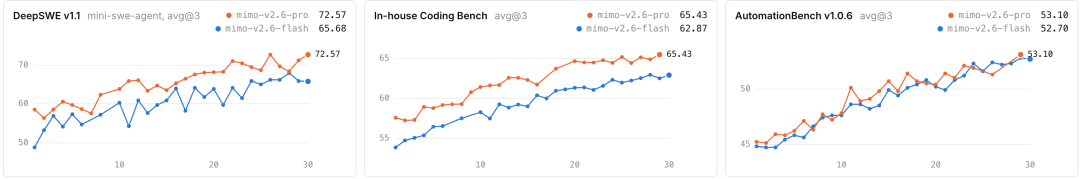
看着各种Benchmark在这几天里,不断的提升,也是真的挺有意思的,而且有一说一,这个曲线,他们的数据集质量,真的是高的离谱了。
他们也完整的产出了一篇技术报告,这个技术报告我觉得太值得学习了,里面讲了太多的东西。
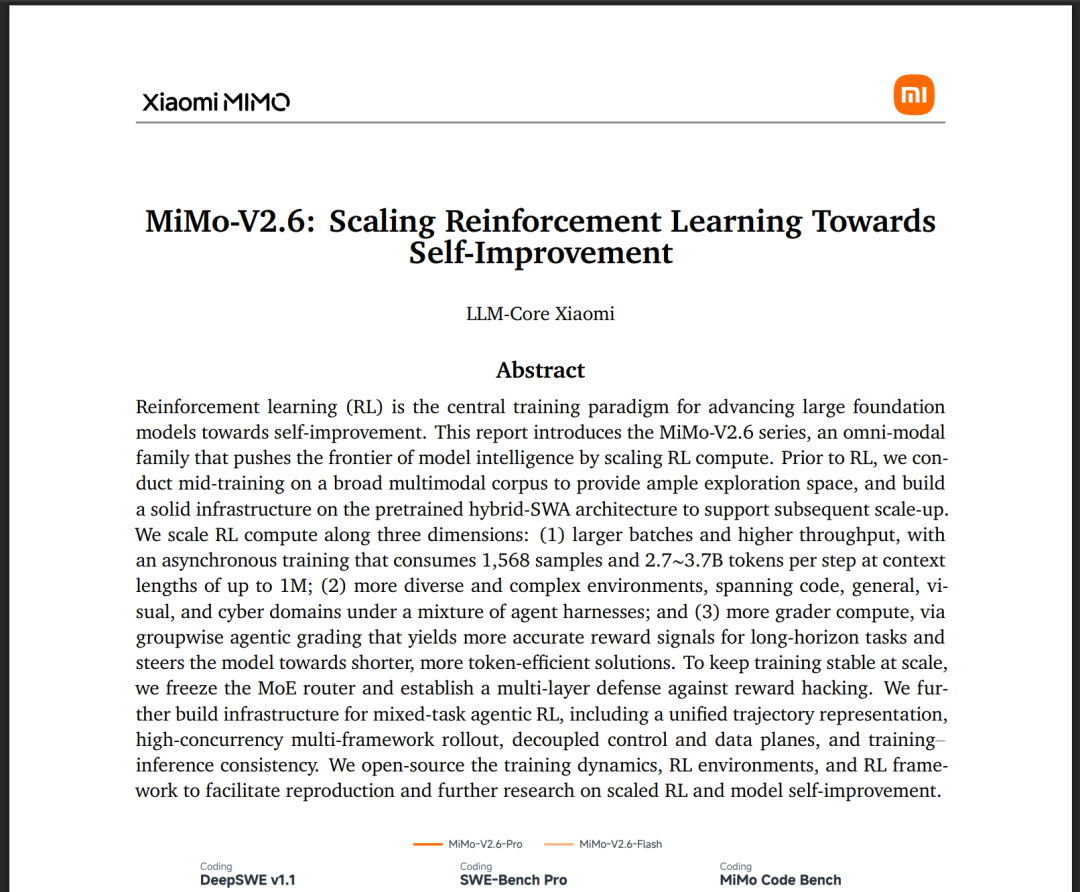
如果你是AI从业者,真的推荐一定要看。。。
网址在此:
https://huggingface.co/XiaomiMiMo/MiMo-V2.6-Pro-RL/blob/main/MiMo_V2_6_technical_report.pdf
罗福莉也写了一篇帖子。
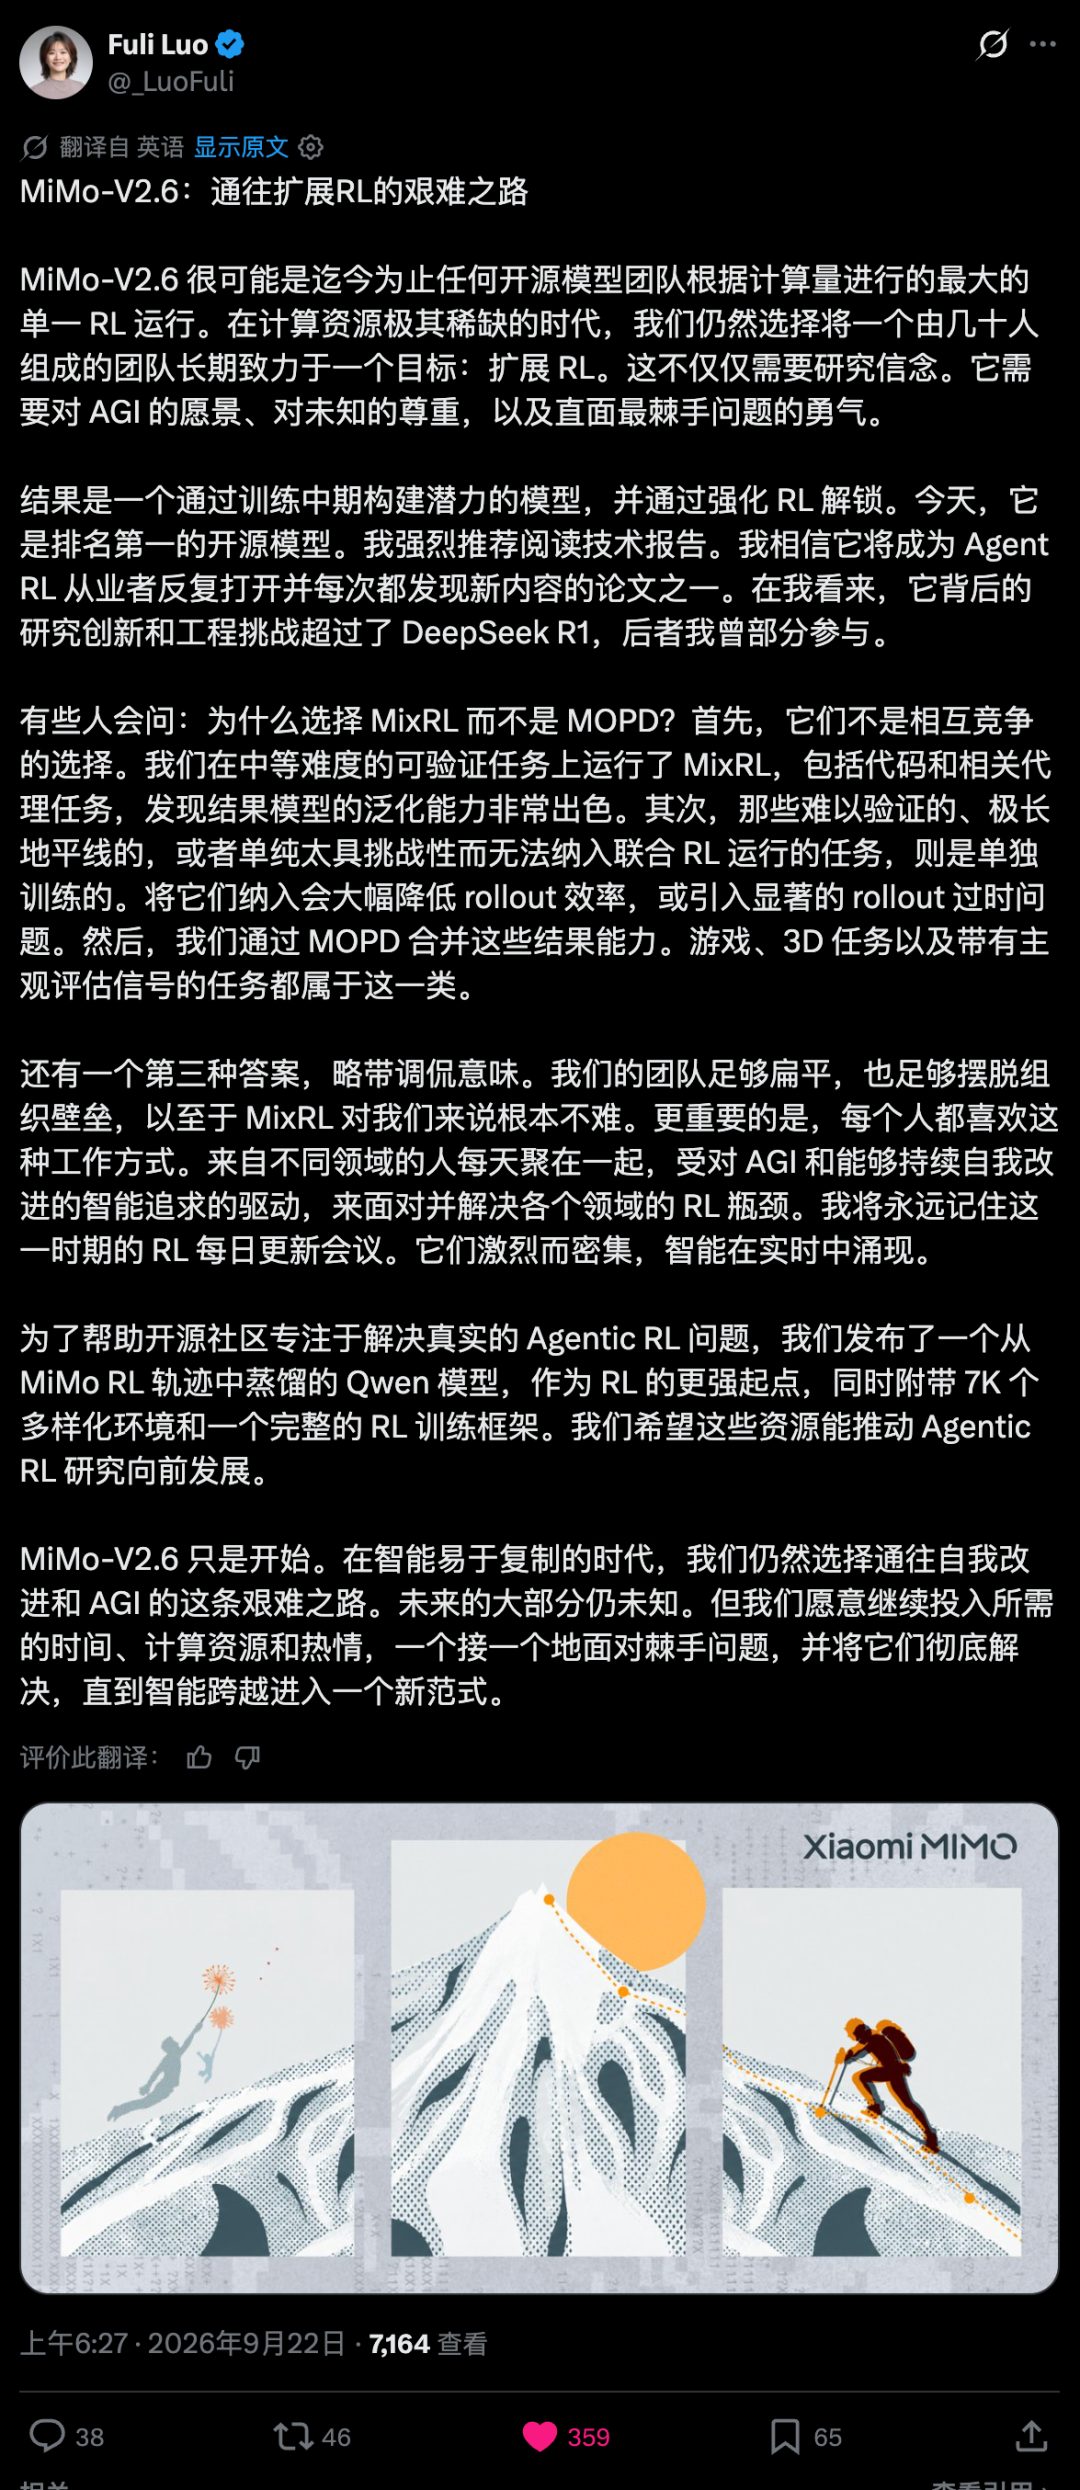
You Only RL Once的思路真的很有意思。
如果想体验MiMo V2.6的话,今天你也有了更好的产品来用。
MiMo桌面客户端,结束了内测,也终于正式上线,出了正式版,向所有人正式开放。
网址在此:https://mimo.xiaomimimo.com/desktop/
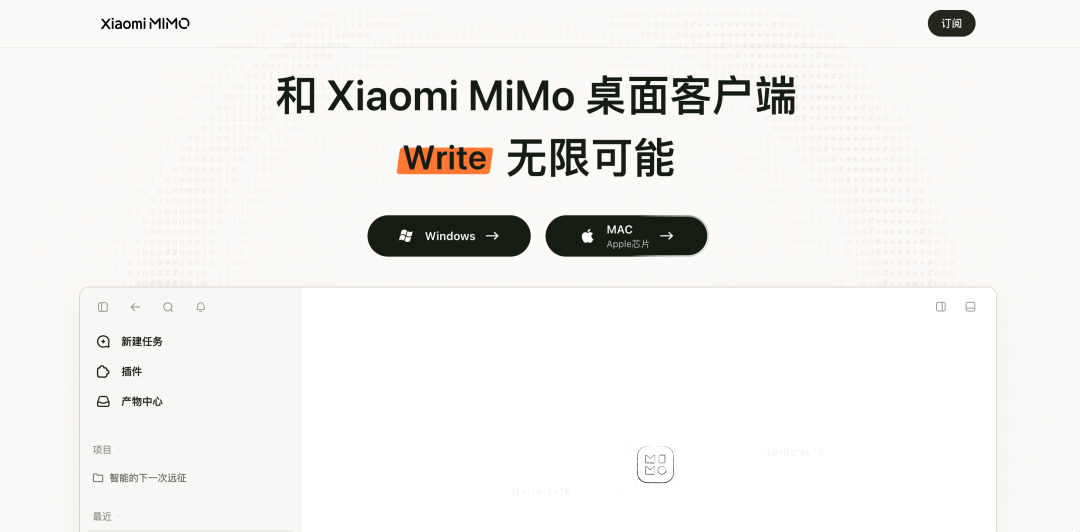
你直接打开MiMo的客户端,就能看到,最新的模型,已经全部上线可用。
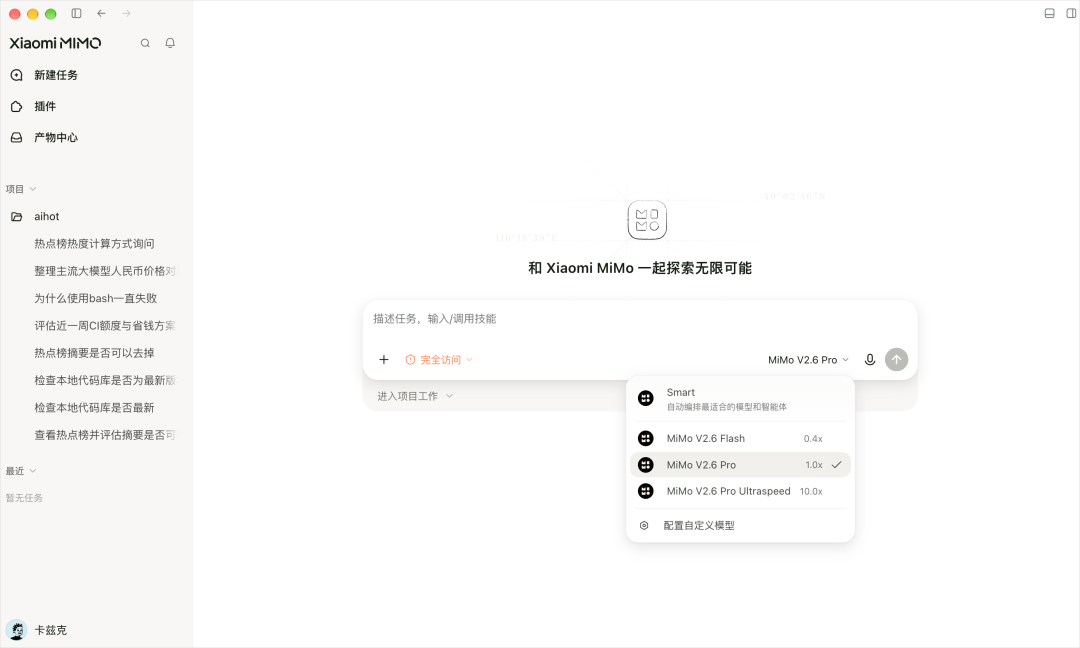
并且MiMo团队格局还贼大,直接可以配置自定义模型,并且贴心的,把各家国产模型都给预设好了。
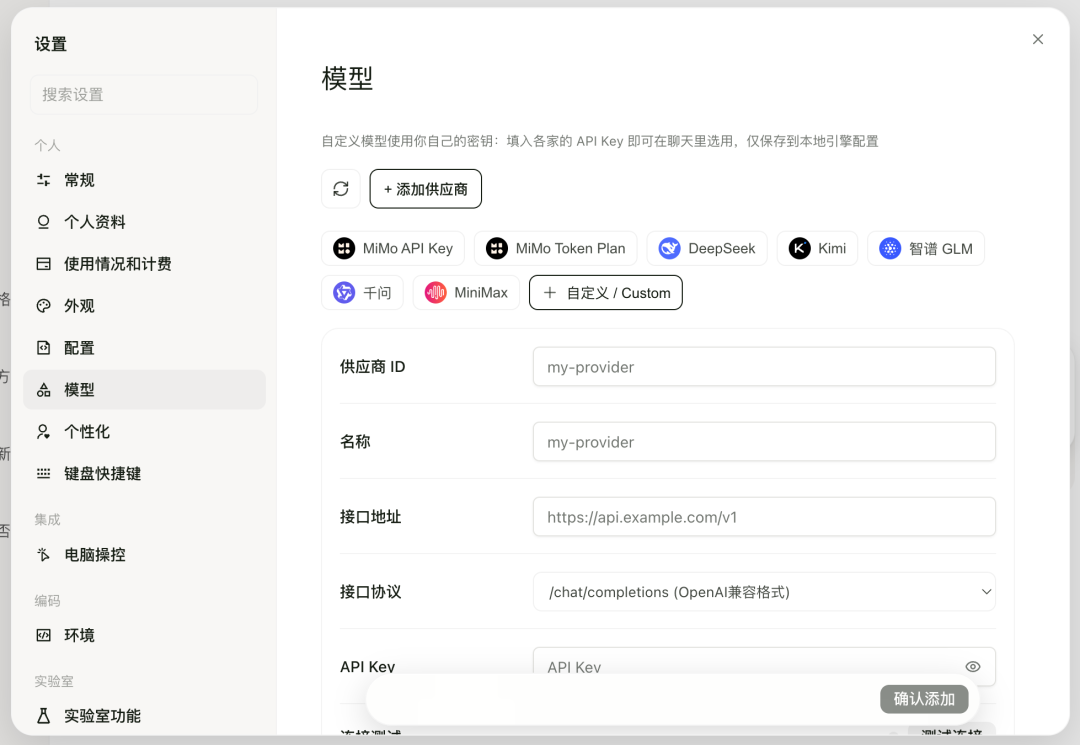
这里如果你之前是买了MiMo的Token Plan的,也可以在这里直接添加,就可以继续在MiMo的客户端里,继续用了。
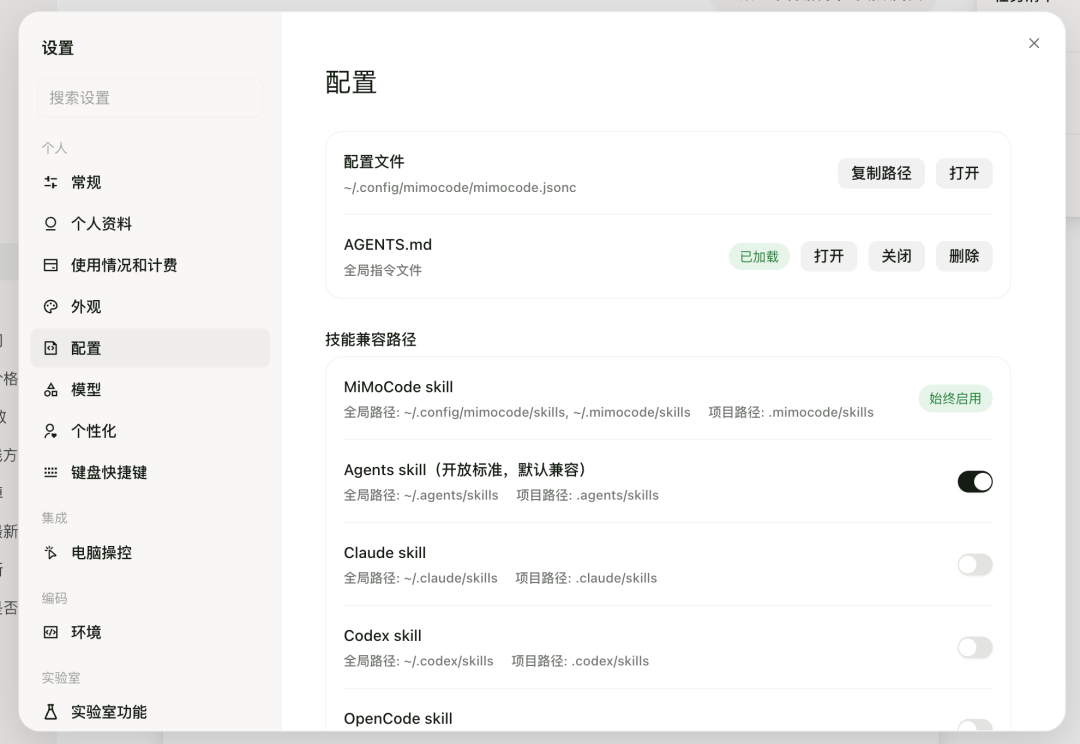
他们的客户端做的也非常的全面和完整,大家下下来以后,可以自己做一下设置。
我们自己也做了一些简单的测试。
基本上还是偏万能型的水桶模型的。
做一些小型的BUG修复,是绰绰有余的,比如说看到一个告警通知或者一个BUG反馈,直接就扔给MiMo V2.6 Pro,基本上3分钟就能定位到问题。
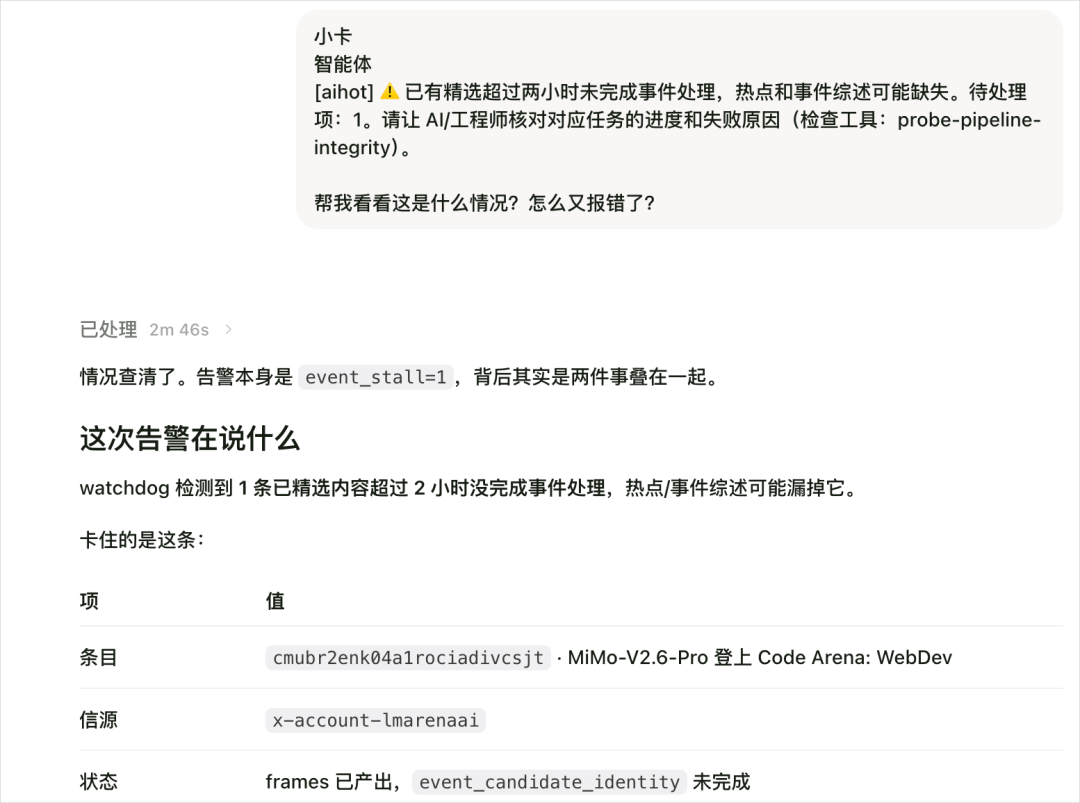
并且会更加主动一些,关联过去的一些问题,来告诉你,有没有还可以举一反三一起解掉的问题。
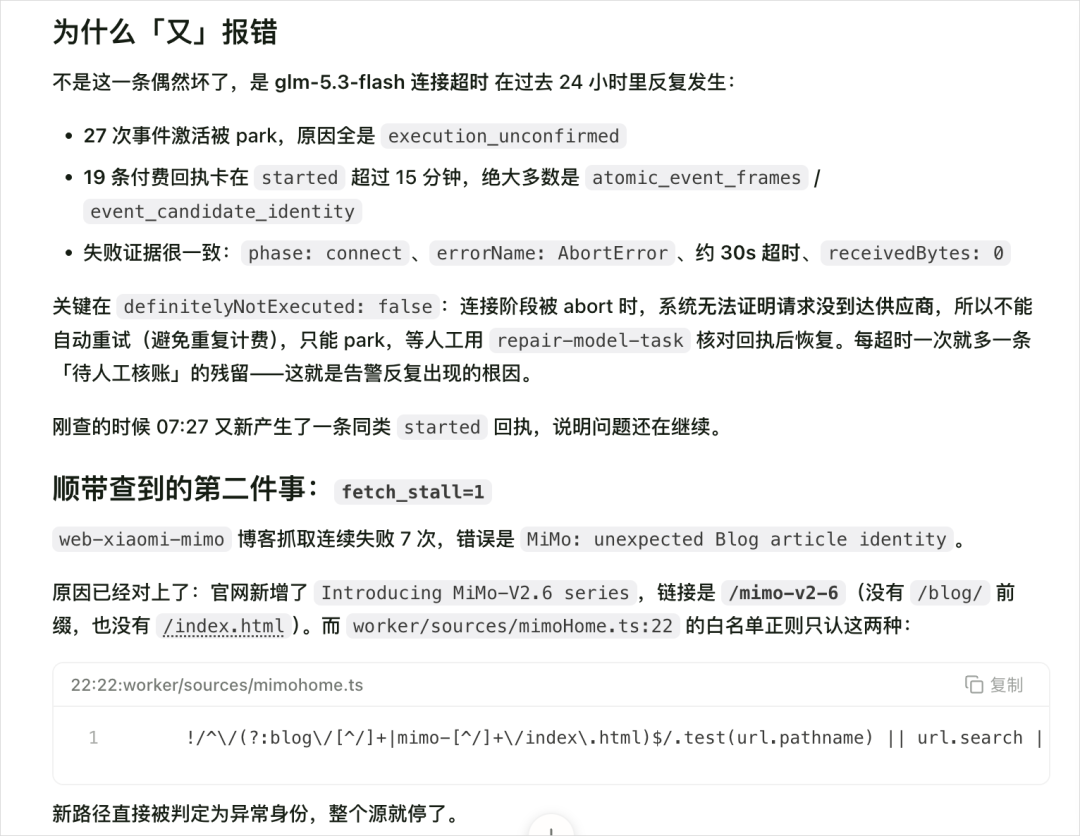
这个主动性,确实是这次MiMo V2.6的特性。
有一个热点算法的重构的大型任务,直接GPT-6 Pro做的规划,交给MiMo V2.6去执行了,目前还在跑,跑了1个多小时了,CI被打回了1次,正在修复准备继续提CI,感觉应该没啥问题。
在前端上,我们现在特别喜欢用建筑设计来测试,一方面可以测审美,另一方面也可以测代码性能。
在我们这个露天足球场的任务上,做的还不错,精细度和整体效果肯定是离GPT-6 Astra那种玩意有一些差距的,整体精细度和性能表现上,我觉得跟Opus 4.8~Opus 5之间。
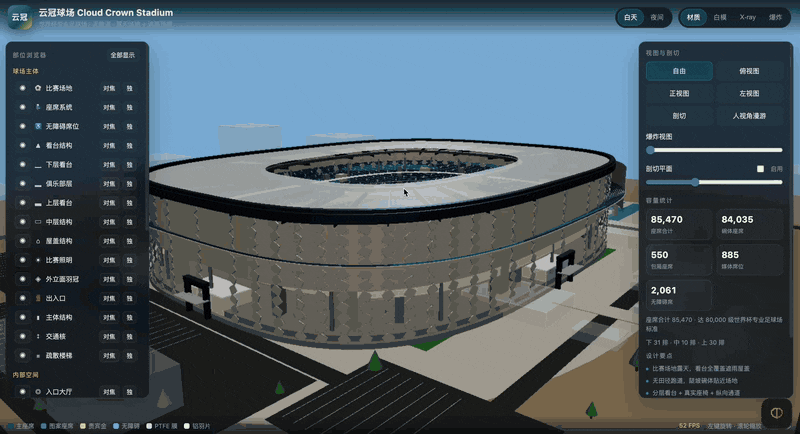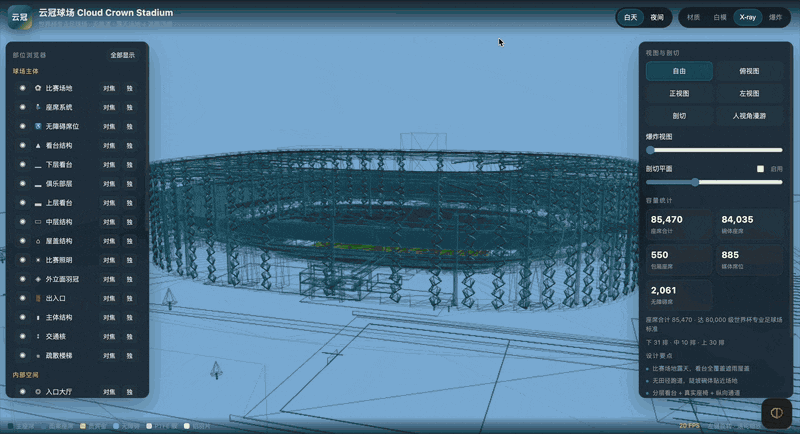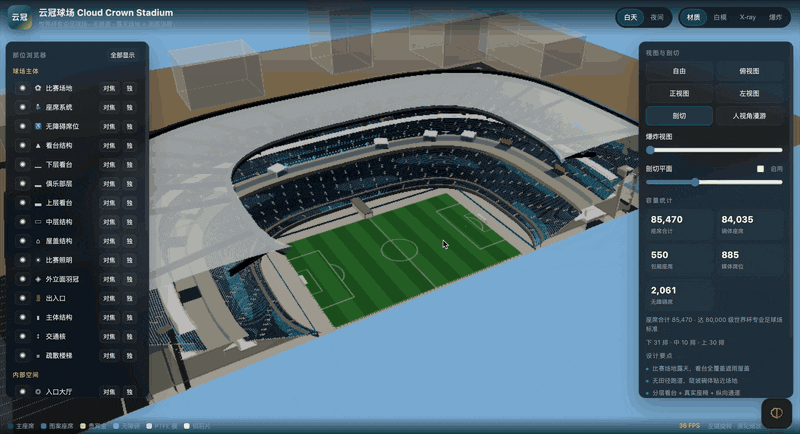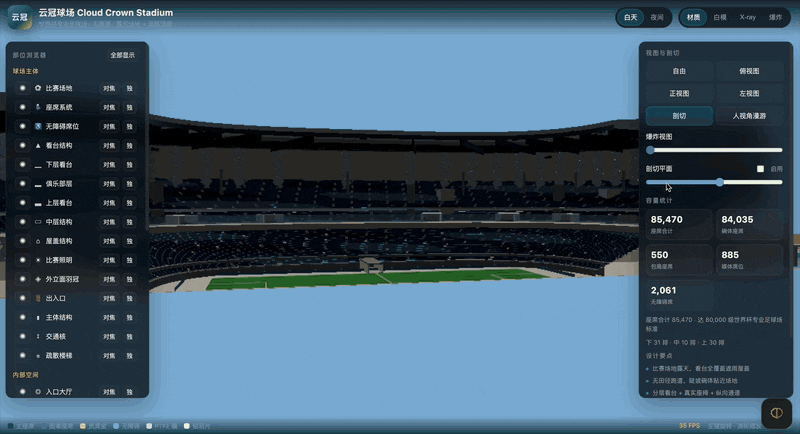
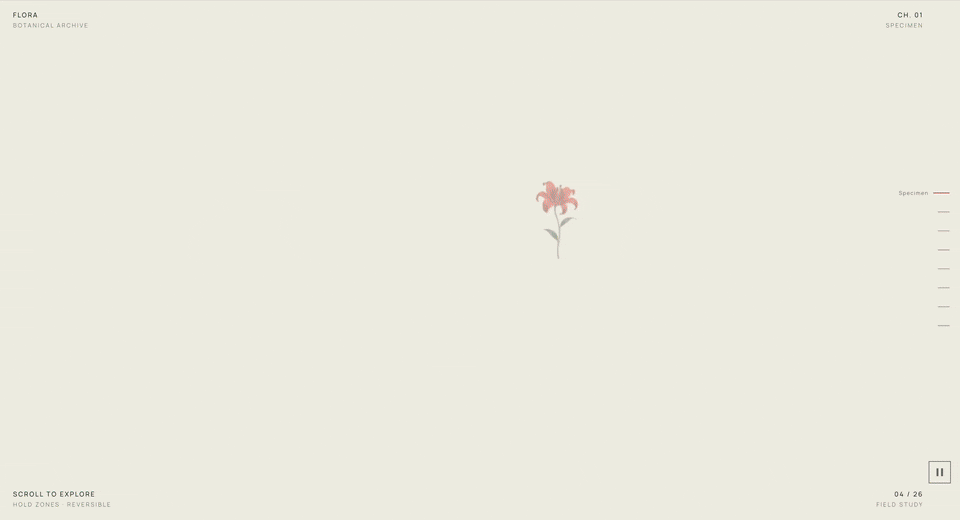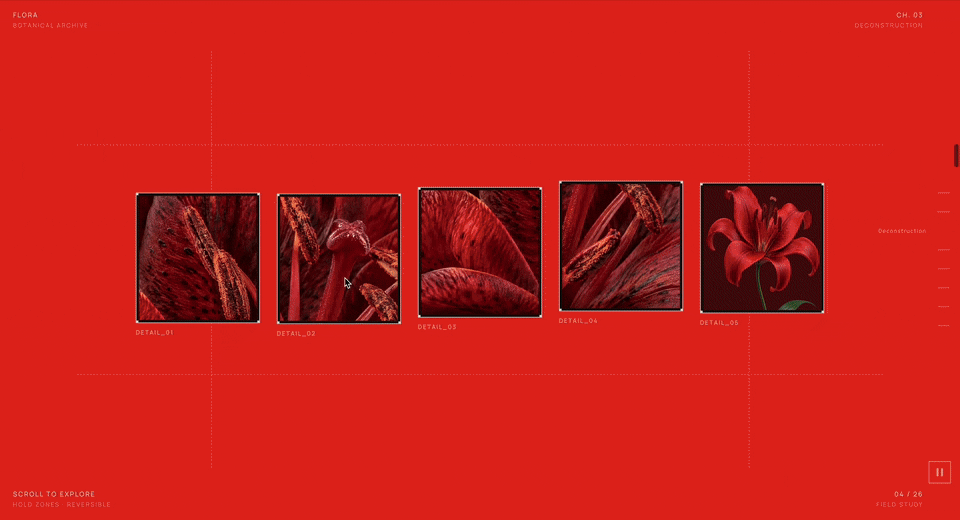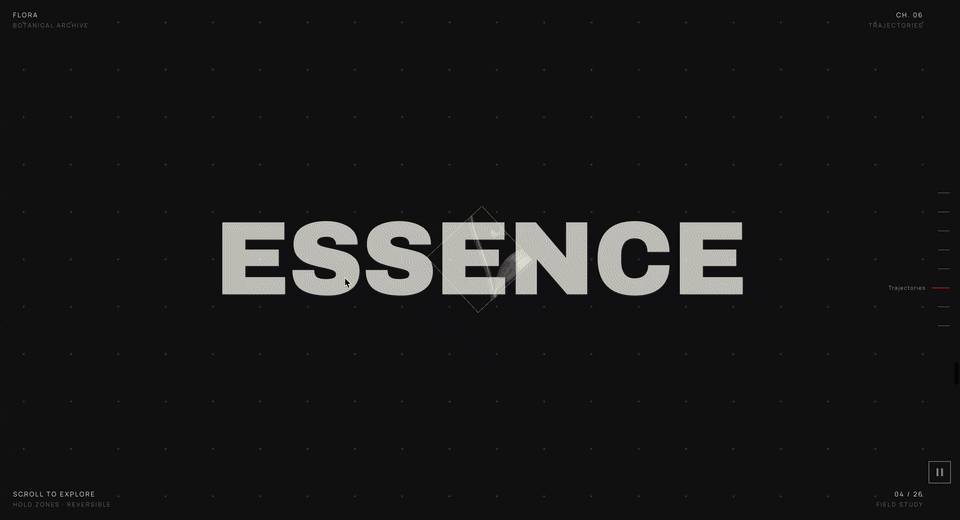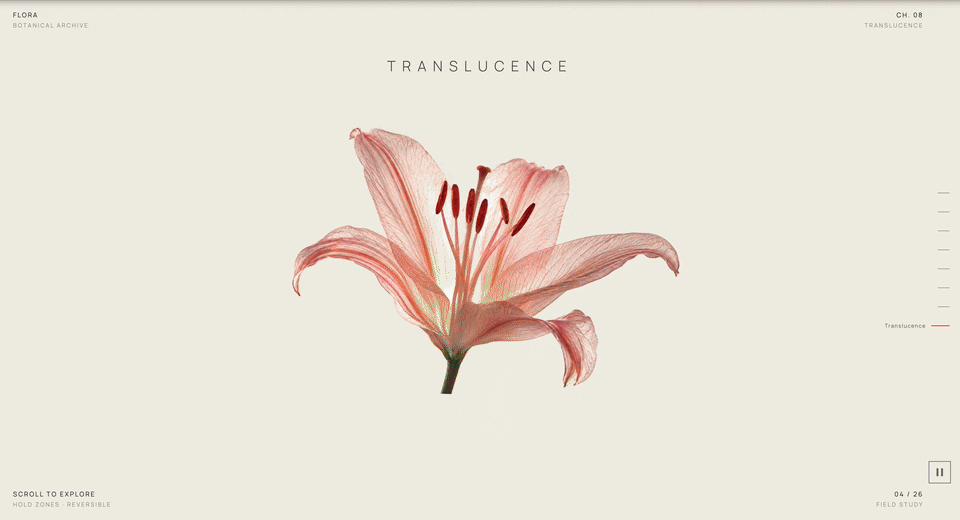
还有这个花朵动效的网页,实现的很不错,性能也足够流畅。
我自己可能又要迭代我的工作流和订阅了。
GPT-6 Astra依然会是我的最强的主力模型,但因为其高昂的价格,所以GPT-6 Pro + GPT-6 Ultra一般来共同帮我完成一个大型项目前端的规划和策划,然后交付到执行层面。
在执行层面,未来会有两种情况。
对于风险较大的工作,比如算法优化、大型重构之类的,我会直接用GPT-6 Astra Max来接着规划开始开发,保证用思考深度来换取在最短的轮次里完成开发,而不是反反复复的提PR过CI然后不断的修改无限循环。
风险一般的其他工作,比如部分单个功能的优化或者BUG修复,基于成本考虑,我可能就直接交给MiMo V2.6 Pro去干了,这个完全没有问题,未来的话可能会看一下GPT-6 Sol的性价比,然后再对比做一下判断。
但是对于大家来说,如果用不了国外模型,那就国内来说,现在MiMo V2.6 Pro可能就是你能用上的最综合水桶的了。
而AIHOT的后端API,无脑切换到MiMo V2.6 Flash上,精准性更高、品味更好、还能继续把我的成本打下来50%,何乐而不为。
哦对了,还有一个事没有说。
MiMo V2.6这次,是全面开源的。
而且没有什么后续开源,在今天模型上线的第一天,已经全面开源了。
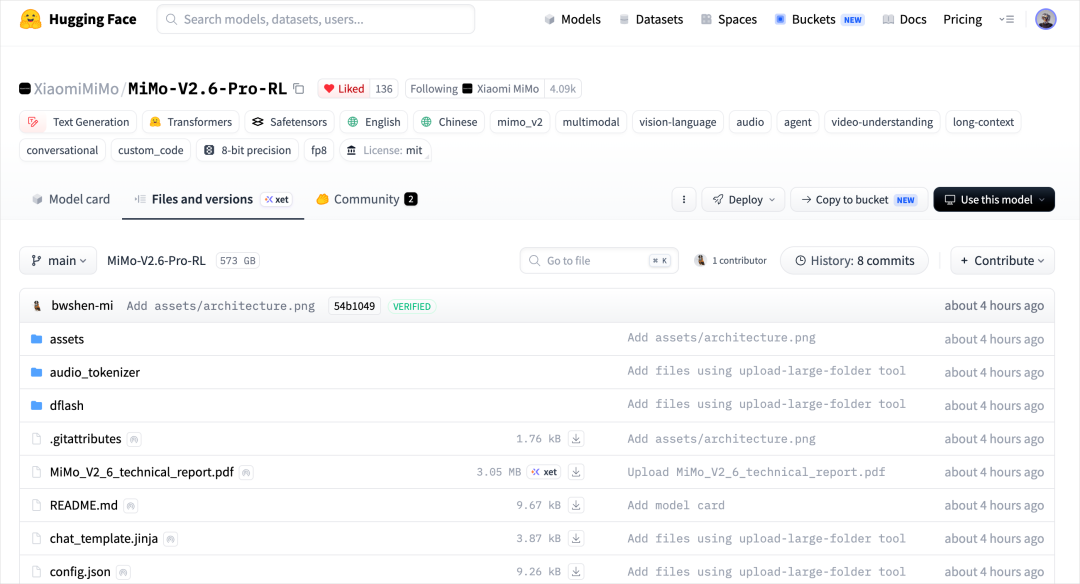
MiMo-V2.6-Pro和Flash的模型权重已经开源,Hugging Face上已经可以下载。
然后还有一个特别有意思的:
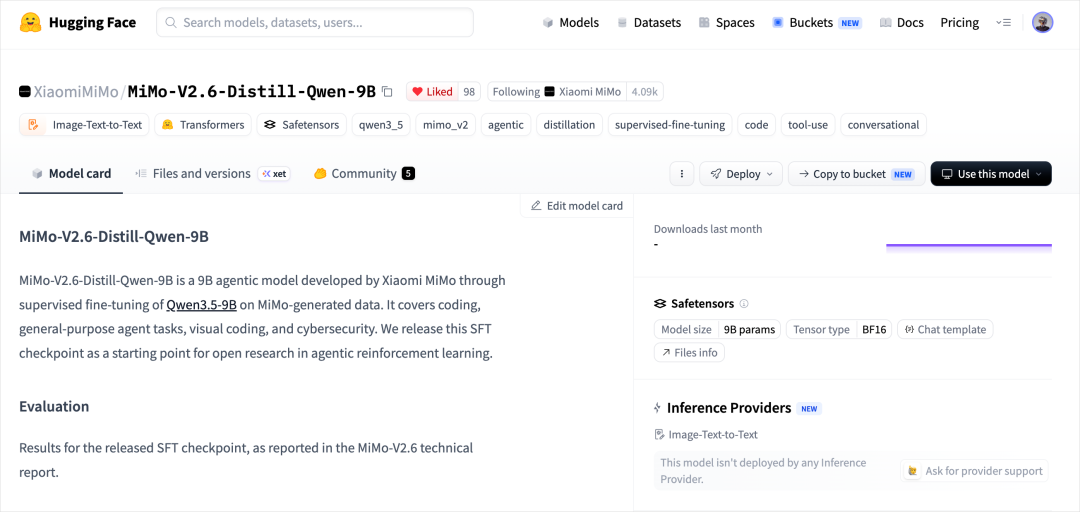
MiMo-V2.6-Distill-Qwen-9B。
他们专门拿Qwen3.5-9B做了一个只有9B的小模型,就是为了让社区里没有几千张卡的人,也能自己去复现他们这一套Agentic RL。
并且,他们还宣布,会一起开放,7000多个高质量RL任务环境。
任何做AI的人,我相信大家都知道,这玩意,有多值钱。。。
MiMo就这么开了。
还有一个mini-harnesses的东西。
都开,全给你开。
那个全是宝藏的技术报告也开。
我只能说,今天罗圣登位。
愿未来,智能属于我们每个人。
免责声明:本文章仅代表作者个人观点,不代表本平台的立场和观点。本文章仅供信息分享,不构成对任何人的任何投资建议。用户与作者之间的任何争议,与本平台无关。如网页中刊载的文章或图片涉及侵权,请提供相关的权利证明和身份证明发送邮件到support@aicoin.com,本平台相关工作人员将会进行核查。